Appearance
集群概览
序言
此文档是Metax集群部署指南,适用于多机环境和集群环境的部署工作。通过环境配置,一个集群环境达到可用及性能正常的标志是通过通信库多机MCCL/DeepEP测试及性能数据达标。
集群的性能和服务器配置(X86/ARM),服务器拓扑(OAM/Balance/Common/Cascade),PCIe的代系(gen4/gen5),网卡的代系(CX6/CX7),交换机型号(200Gbps/400Gbps),Metax GPU卡型号(C550/C500/C500X/C290 etc.)密切相关,需要对集群性能进行特定分析。
集群组件介绍
计算集群通常由服务器和交换机组成,服务器包含CPU、GPU、网卡等,普通服务器间通过网卡、网线和交换机相连,构建一个基本的计算集群系统;另外还有超节点集群,服务器间通过GPU上特定的物理链路(如Metaxlink)进行机间互联,互联有机间直连和通过特定Switch(如PCIE Switch)互联两种形态。
服务器介绍
服务器类别
服务器种类主要有浪潮、新华三、立讯、联想、中兴、阡视、同泰怡等,每个服务器的软硬件配置各有差异。常见的机型为单机8张GPU卡;目前为节省机头成本,也出现了许多单机16张GPU卡的机型。
服务器分为PCIE机型(GPU通过PCIE Switch接口连接)和OAM机型(GPU通过UBB板全互连),另分为液冷和风冷。
服务器拓扑
PCIE型服务器常见的拓扑有Balance、Common、Cascade之分,不同的拓扑对GPU 8卡和多机通信有影响。
Metax GPU介绍
沐曦GPU目前有C500和C600系列,另还有N系列。每型GPU规格有较大差别,本章节主要介绍和集群通信相关属性。
互联属性
沐曦GPU间除了PCIE互联外,还通过MetaxLink互联,每种型号GPU的MXLink链路数量和带宽各有差异。
C500:单卡单芯,每卡3条MetaxLink,每条链路理论带宽64GB/s;
C550:单卡单芯,每卡7条MetaxLink,每条链路理论带宽64GB/s;
C588:单卡双芯,每芯7条MetaxLink,每条链路理论带宽64GB/s;双芯间通过4条MetaxLink互联;
C600:单卡双芯,每芯3条MetaxLink,每条链路理论带宽32GB/s;双芯间无MetaxLink互联;
N300:单卡单芯,每卡3条MetaxLink,每条链路理论带宽32GB/s;
C600/N300每颗GPU芯片自带一个ETH IP(另称MXRDMA或MRDMA),支持RDMA协议,理论带宽200Gbps(25GB/s)。
GPU间的PCIE互联带宽,由服务器使用的PCIE Gen4(32GB/s)或Gen5(64GB/s)决定。
通信规格为芯片敏感信息,请注意信息安全。
设备序号
由于服务器的PCIE插槽,及操作系统对设备识别顺序的差异,会出现Slot id和Device id不对应的情况,为了充分发挥各服务器的通信理论性能,需要设置特定的MACA_VISIBLE_DEVICES。
常见的卡号顺序如下:
1、C500,MACA_VISIBLE_DEVICES=0,1,8,9,2,3,10,11,4,5,12,13,6,7,14,15(只限阡视服务器)
2、C588,MACA_VISIBLE_DEVICES=0,1,2,3,6,5,4,7,10,9,8,11,14,15,12,13(Intel CPU)
MACA_VISIBLE_DEVICES=0,1,6,7,2,5,4,3,10,9,8,11,12,13,14,15(海光 CPU)
3、C600,MACA_VISIBLE_DEVICES=0,4,8,12,6,2,10,14,1,5,9,13,7,3,11,15
上述顺序能最大化发挥整机中2卡、4卡、8卡、16卡通信,可满足大模型的对应切分或者只使用部分卡(卡数为2的n次幂)的场景。该顺序也会因为服务器型号不同而发生变化,如测试性能出现异常可联系通信库团队支撑。
网卡介绍
RDMA网卡主要有迈络思、博通、云脉、云豹、中兴等产品型号,另有C600/N300自带的MXRDMA,目前沐曦都基本完成了适配。
计算集群的网络有两种模式,RoCE网络和IB网络,RoCE网卡搭配RoCE交换机,IB网卡搭配IB交换机,模式要对应。目前只有迈络思的网卡有IB和RoCE两种模式,其他厂商的网卡只支持RoCE模式。
Mellanox常见网卡型号有CX7(ConnectX-7)和CX6(ConnectX-6),CX7带宽400Gbps(50GB/s),CX6带宽200Gbps(25GB/s),网卡有单网口和双网口两种类别,如是双网口,每个网口均分带宽。
PCIE服务器一般是每个PCIE Switch下各配置1张网卡,单机8 GPU服务器一般是2张网卡,单机16 GPU服务器一般是4张网卡;OAM服务器常见是4张网卡,满配8张。
集群的性能和网卡的配置强相关,需要了解网卡基本规格。
交换机介绍
常见的RDMA交换机有新华三、浪潮、华为、中兴、云脉等产品,交换容量是核心性能指标,其决定了集群网络的层级,常见的有25.6Tbps和64Tbps。
超节点介绍
使用MetaxLink等特定链路通过机外直连或机外Switch连接的多机系统,称为超节点。目前有C500X,C550 DF,C550 3D Mesh等机型。
集群网络拓扑
集群的网络通常有三种,计算网卡构建的计算网络、存储网卡构建的存储网络、管理网卡构建的管理网络。
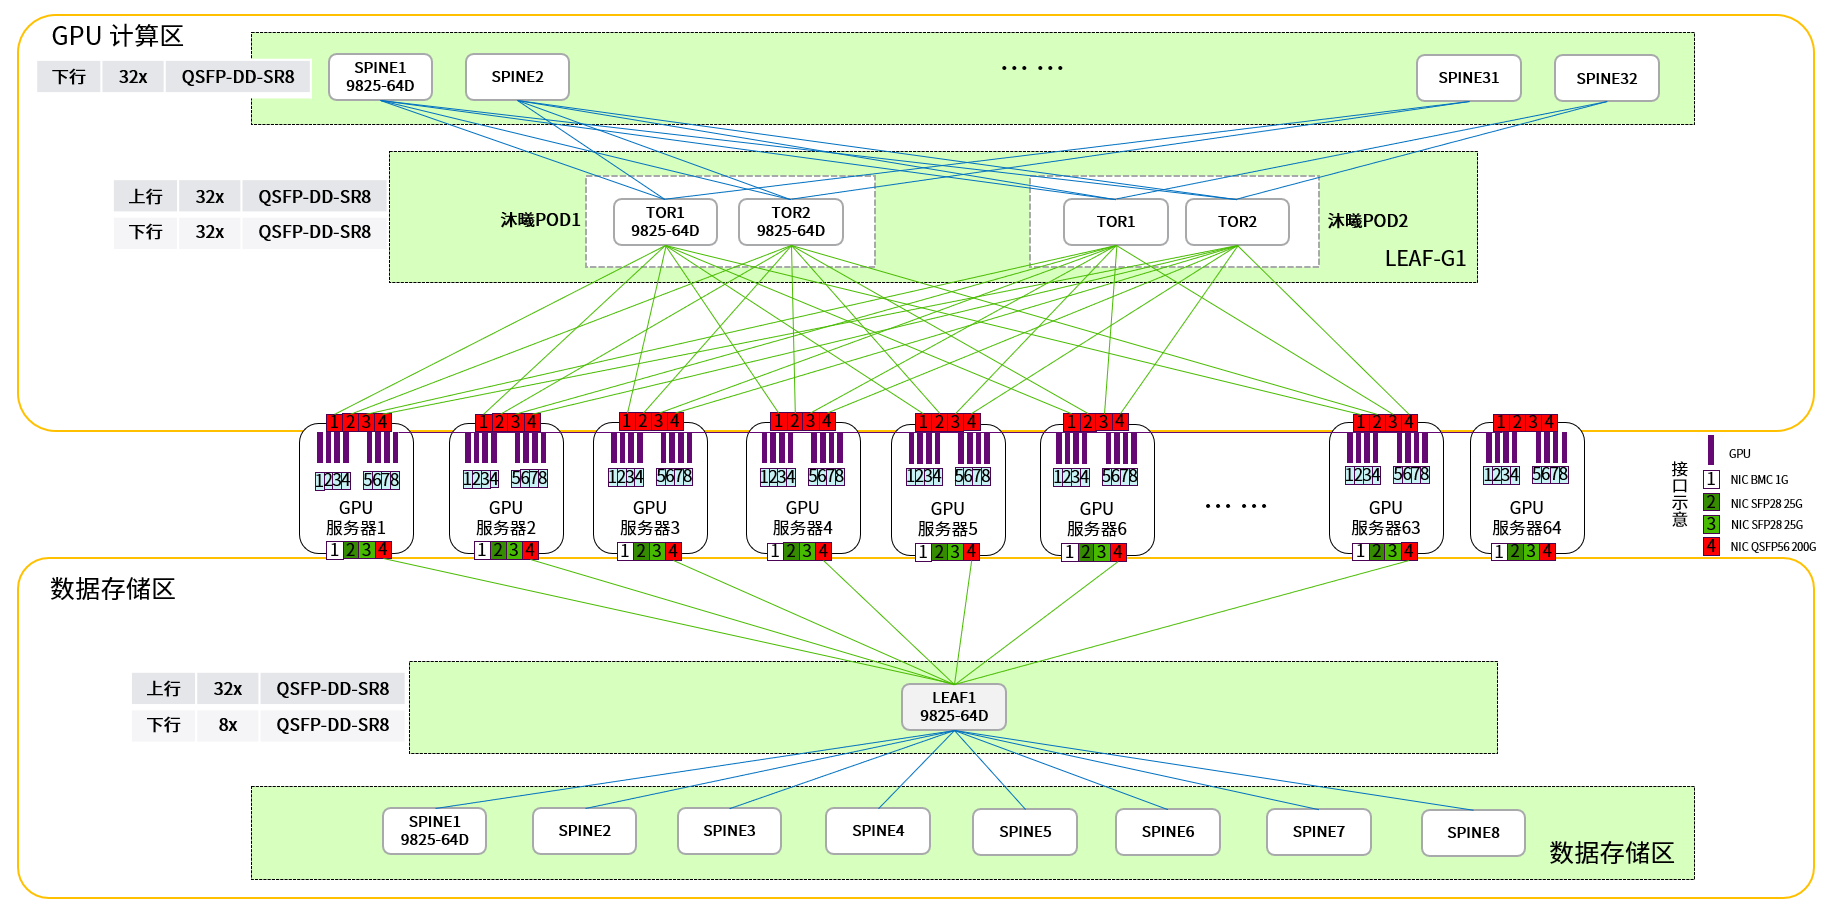
计算网络常见的有Fat-Tree拓扑架构和Spine-Leaf拓扑架构。
下图为常规的集群Spine-Leaf网络拓扑图,可构建百卡千卡集群。
集群通信库概述
支持千卡万卡集群工作的核心软件为通信库,沐曦通信库技术方向分为MCCL类、EP类、MPI类及其他开源通信库类等,使用哪种通信库取决于上层AI框架。
MCCL类
1、MCCL (Metax Collective Communication Library),类NCCL,兼容NCCL API所有接口;
2、MXCCL (Metax X Collective Communication Library),异构通信库,可构建多厂商GPU集群。
通过MXMACA SDK包发布。
EP类
1、MXDeepEP,基于开源DeepEP适配,支持在沐曦各类芯片上运行DeepSeek/LongCat等MoE大模型;依赖MXShmem及MXGDRCopy。Deep在所有芯片上支持internode ll算法,在全互联拓扑芯片(C550)上另支持internode normal和intranode算法(非全互联拓扑暂不支持)。
2、MXMesh,沐曦自研通信库,主要面向单机或者超节点机型,使用机间Link代替RDMA网络进行EP传输,兼容DeepEP接口。
MXDeepEP和MXMesh对topk、hidden size、experts num、rank num等支持情况,请参考附录EP通信库支持规格。
通过MXMACA SDK Python包发布。
MPI类
MPI / UCX,基于开源MPI / UCX适配,支持在沐曦芯片运行HPC等应用。
通过MXMACA SDK包发布。
其他开源通信库
MIXL,基于NIXL适配,支持LMCache及Dynamo等框架;StepMesh等开源通信库。
通过MXMACA SDK Python包发布。