Appearance
集群通信测试
集群通信测试包括GPU P2P测试、网卡IB Test测试、及多卡多机通信库测试。
通信库测试通过是集群达到可用的标志。
通信库性能数据会根据硬件配置不同产生差异,性能数据是否合理需进行特定分析。
常规性能数据见下述截图(C500,PCIe Gen5,Common拓扑,400Gbps RoCE网络)。
P2P和网卡测试是基本测试,用于检测Metalink/PCIE/NIC是否处于正常状态,测试结果符合预期后再进行mccl test。
查看设备及拓扑
通信库测试和单机、网络拓扑强相关,测试前,需了解CPU、GPU、NIC和交换机的连接关系,才能判断集群通信的正确性。
拓扑的判断一般通过lspci、mx-smi等命令综合判断。
lspci查看硬件设备
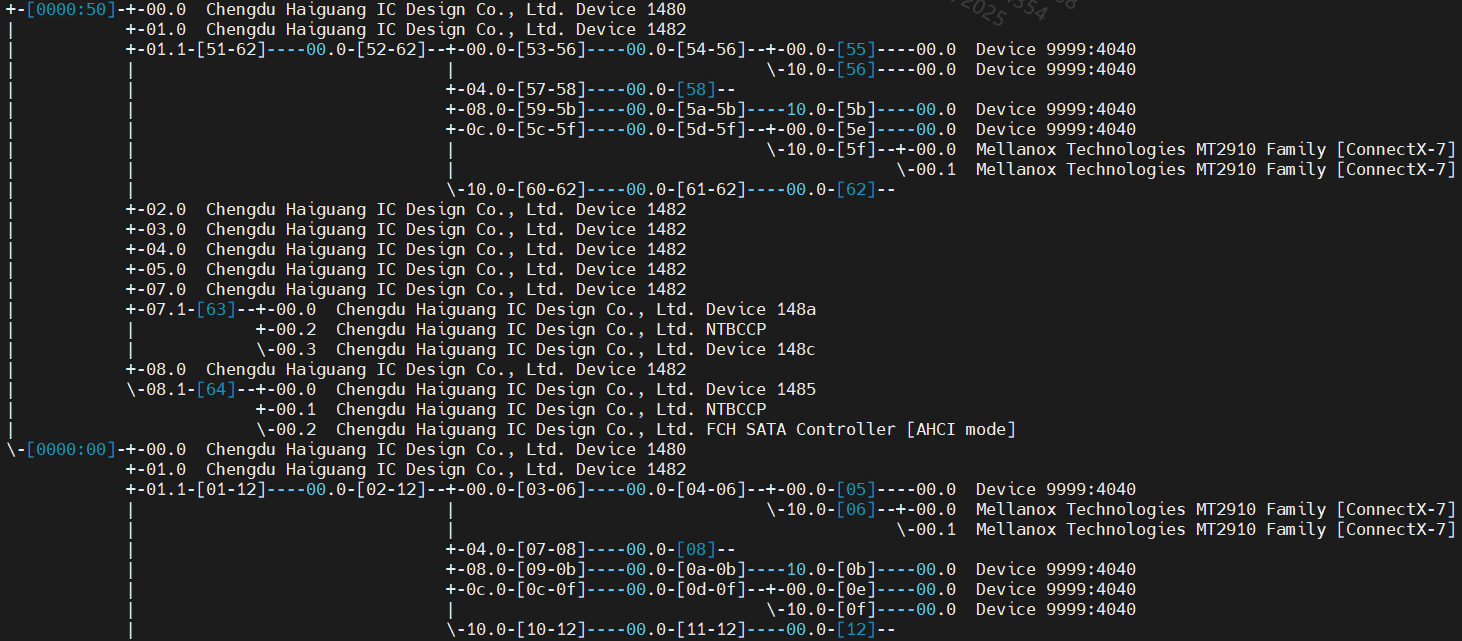
通过lspci -tvvv查看网卡类型。如下图中的ConnectX-7字段为网卡设备,配置为单机两计算网卡,每四个GPU对应一张网卡,网卡为CX7双口网卡。
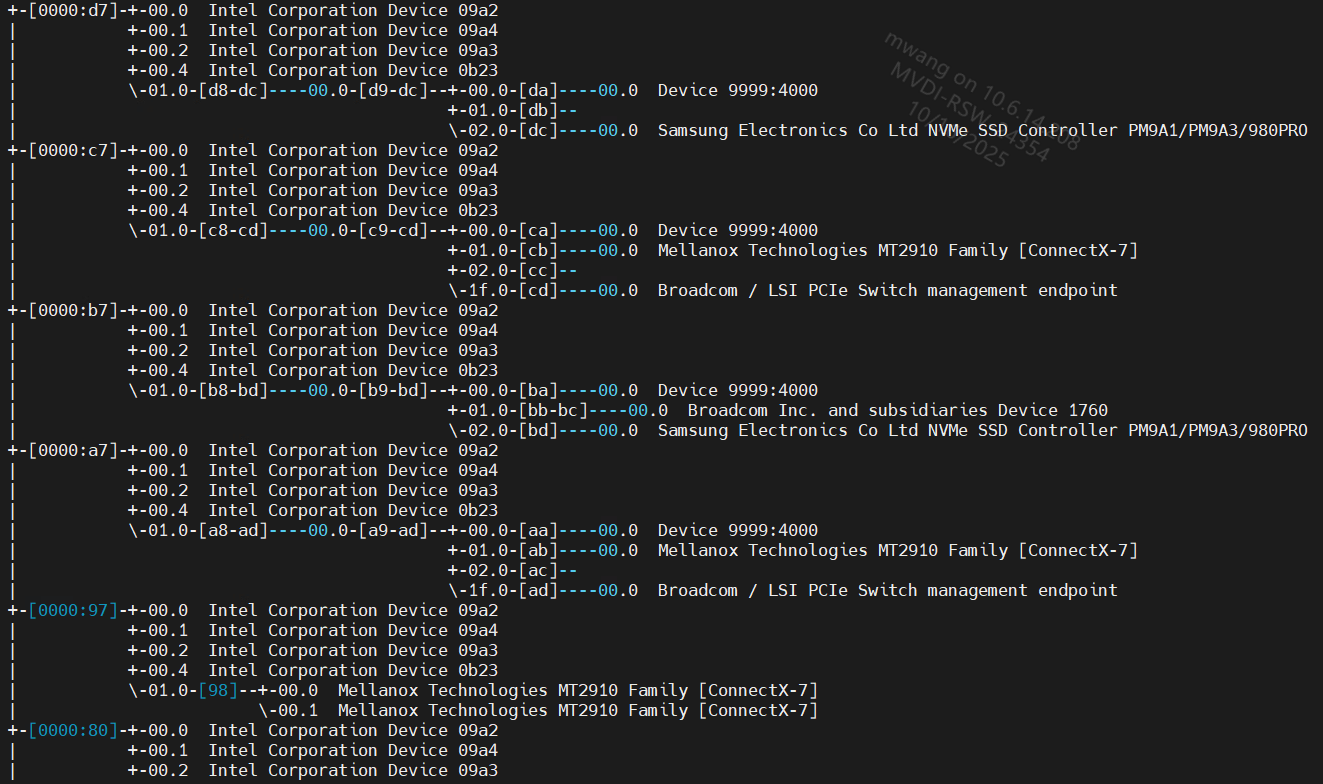
如下图中配置为单机四张单网口CX7计算网卡。
mx-smi判断拓扑
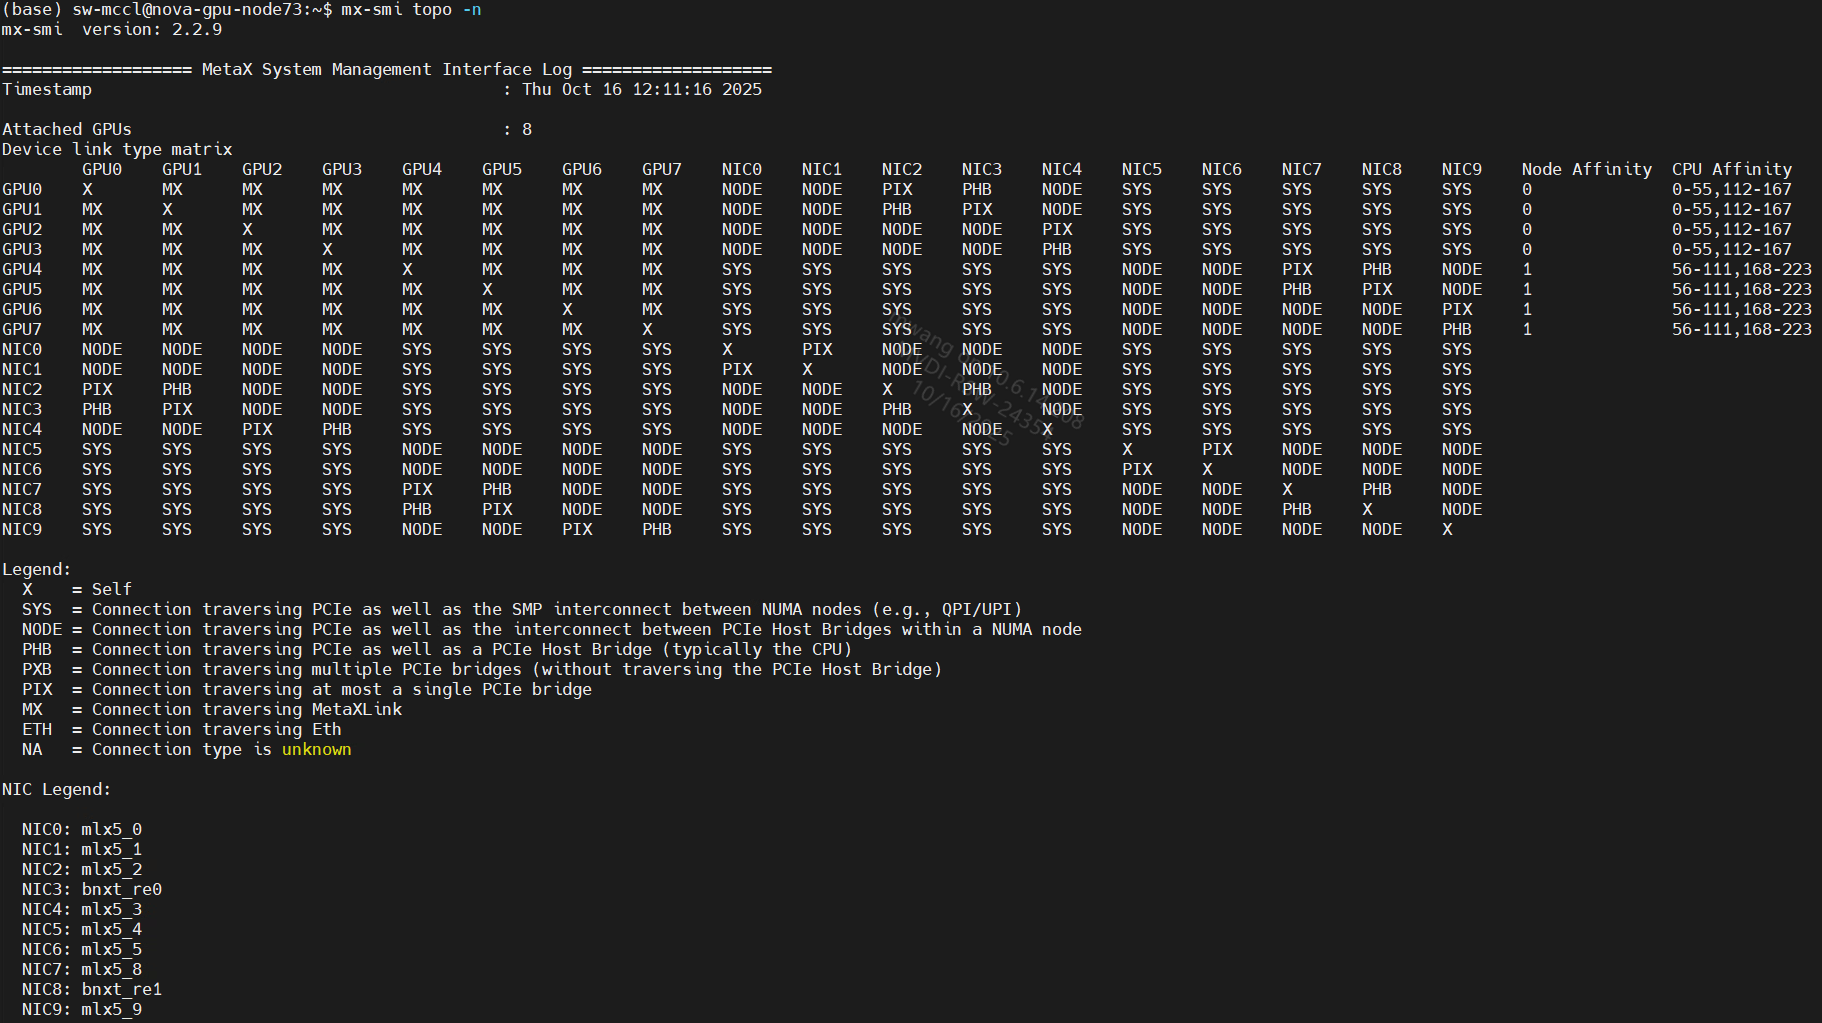
通过mx-smi判断gpu和nic拓扑。
P2P测试
P2P测试是在UMD层面测试MetaxLink/PCIE/UPI的通信带宽(软件上不涉及通信库)。适用于单机和多机超节点场景,不适用于通过网卡连接的多机。
P2P单机测试
1、安装maca包
2、cd /opt/maca/samples/mccl_tests/benchmark
3、bash p2p.sh (bash example.sh)(测试耗时和卡数相关,8卡测试耗时小于1分钟)
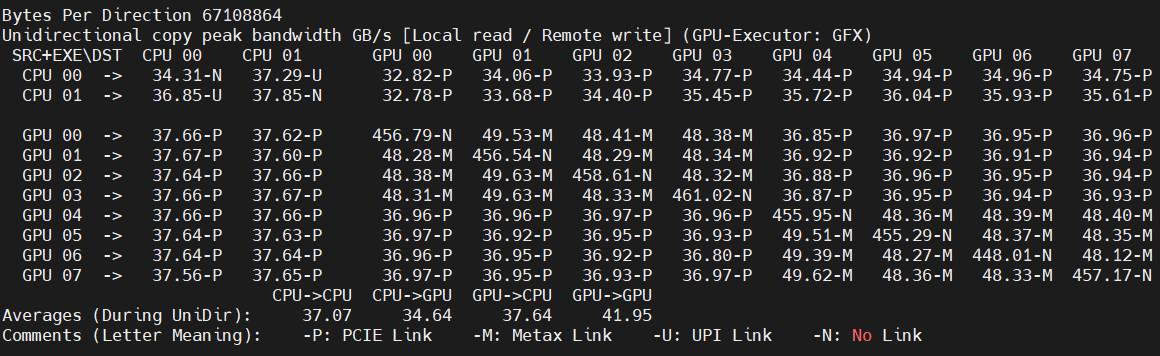
结果一般如下(Common拓扑,Gen5;根据服务器配置和拓扑不同,数据会有差异),根据数值后面的字符(P/M/U/N,字母解释见下图最后一行)来判断GPU间的默认传输链路(可通过步骤4进一步核对),并做带宽的合理性判断。
4、测试数据检查需要用mx-smi对比来看
执行命令mx-smi topo -m 查看gpu之间的连接类型
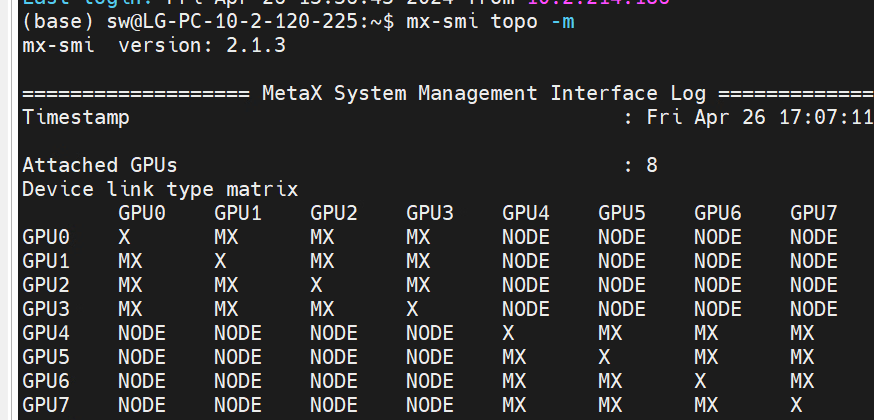
常规情况的带宽值:
1、Metaxlink链路:两GPU通信带宽要达到50GB/s(C500系列)或25GB/s左右(C600系列)左右;
2、PCIE直连链路:带宽可达到50GB/s(gen5)或者25GB/s(gen4);
3、PCIE互联且经过CPU的链路:NODE/SYS连接的通信带宽上限受限于CPU,Intel PCIE Gen5的配置下,NODE连接的两GPU通信带宽要达到35GB/s以上,SYS连接的两GPU通信带宽要达到30GB/s,CPU和GPU间的通信带宽为30GB/s左右;海光CPU的带宽值略低。
P2P多机测试
该项测试只适用于超节点机型,通过使用Scale up Link连接的多机链路,如C500X Dragonfly (Switch),测试前需要保证机器间training成功。
1、安装maca包,training多机
2、cd /opt/maca/samples/mccl_tests/benchmark
3、bash dragonfly.sh(需要根据机器IP,测试机器数量等信息,修改脚本)
测试效果图如下(4机32卡):
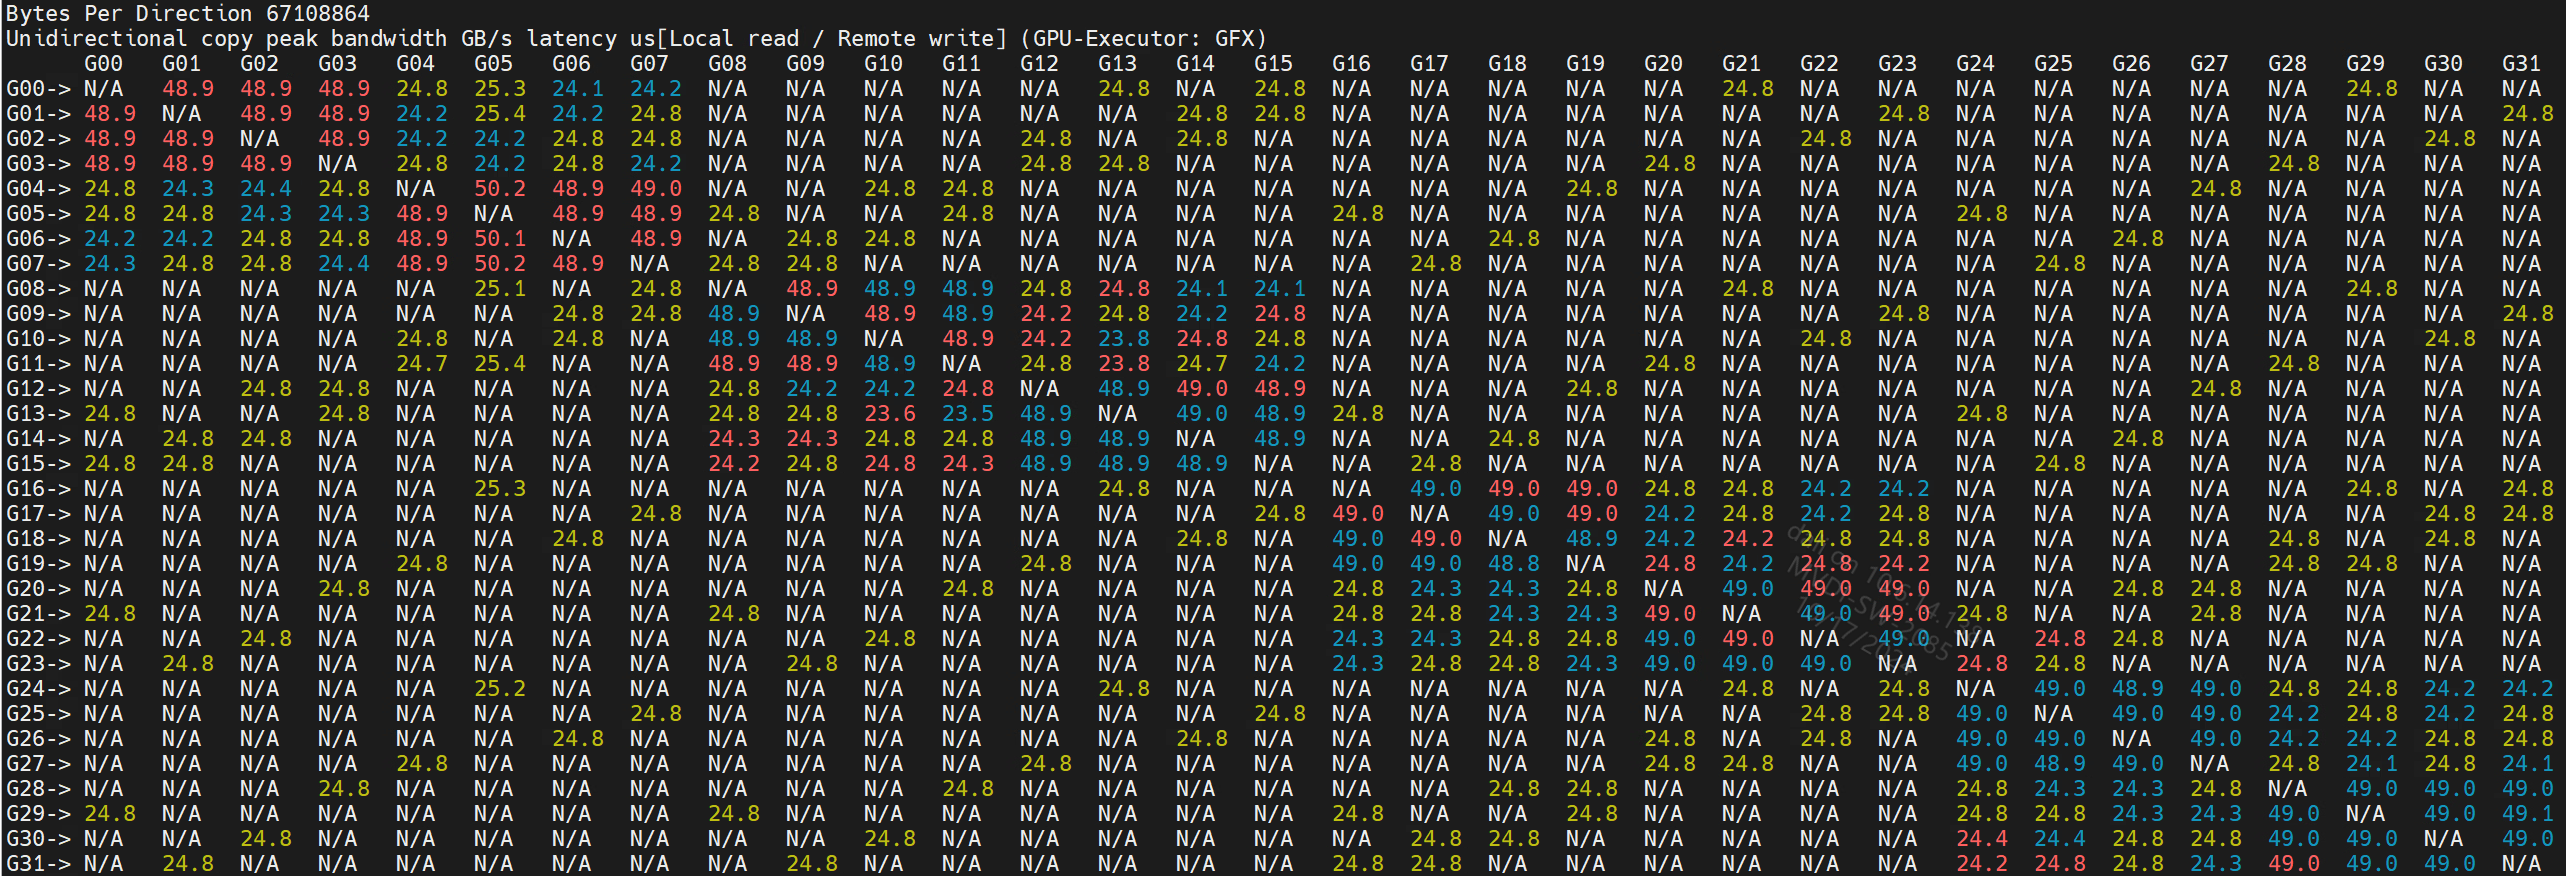
红色数字为机内X16 Lane MetaxLink,黄色数字为机间X8 Lane MetaxLink,蓝色数字为机内跨RC通信。
IB/RoCE网卡测试
IB/RoCE网卡测试用来单独验证网卡是否处于正常状态,在单机和多机上都可进行测试,ib perf bench已发布在maca包,目录/opt/maca/samples/mccl_tests/ib_perf,推荐参照该目录下的server.sh/client.sh脚本进行测试,也可参考下文命令进行测试,测试参数可查阅开源rdma ib perf test官方文档或本文档下述描述。
测试网卡时,要明确测试机器的网卡类型、配置及拓扑,尤其要注意网卡是单口还是双口类型,也要区分出计算网卡、存储网卡及管理网卡,可通过lspci -tvvv和ibstat命令综合判断。
常规网卡测试
下述以多机测试为例(10.2.122.225和10.2.122.226,226作为server端)。
#server端执行命令:
/opt/maca/samples/mccl_tests/ib_perf/tests/ib_write_bw -a -F --report_gbits -d mlx5_0 --use_maca=0
#client端执行命令:
/opt/maca/samples/mccl_tests/ib_perf/tests/ib_write_bw  -a -F --report_gbits -d mlx5_0 --use_maca=0 10.2.122.226
400G网卡性能截图
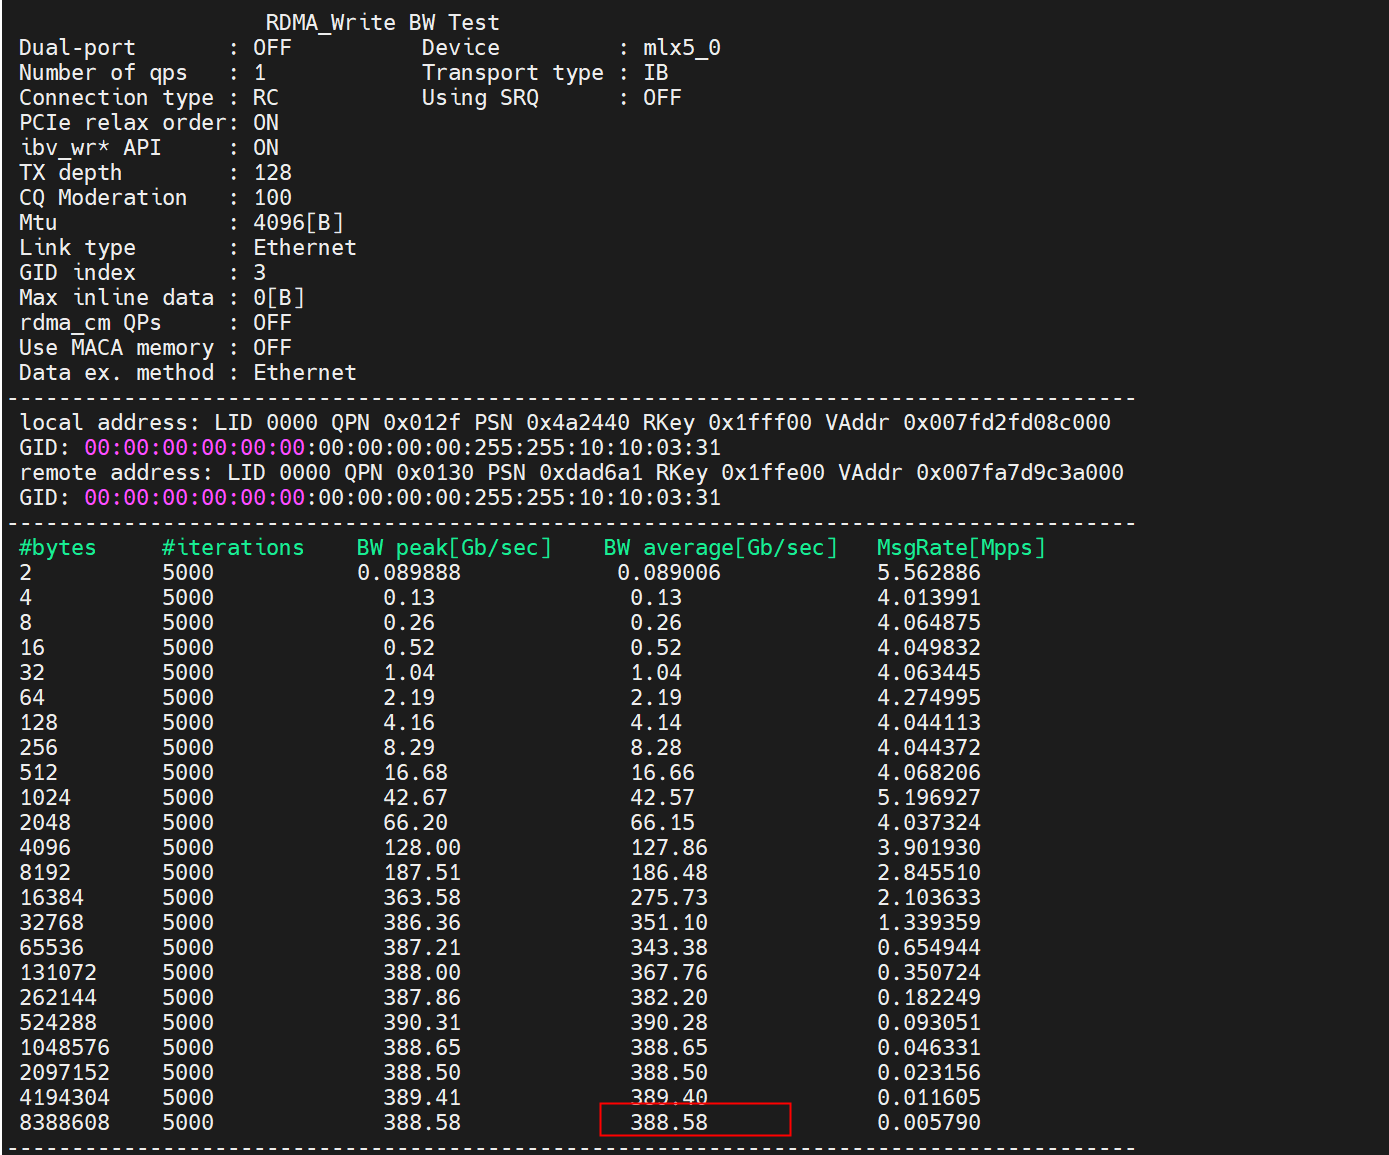
参数解释
-a : 使用测试size为2~2^23 Bytes
-b : 测试双向带宽,不加-b仅测试单向带宽
-d mlx5_0 : 表示用网卡设备mlx5_0来进行测试,其他网卡设备名字可通过ibstat命令查看
-F : 表示测试开启CPU高频模式
-x 3 : RoCE网卡测试需要,-x 3表示使用RoCE 的gid index为3
--use_maca=0 : 表示用gpu0 的hbm来做网卡mlx5_0的带宽测试,如果gpu0和网卡mlx5_0在物理拓扑上距离较远,应当指定物理拓扑上距离较近的gpu来测试,方能充分发挥网络带宽。
不使用--use_maca表示用cpu memory来做测试。
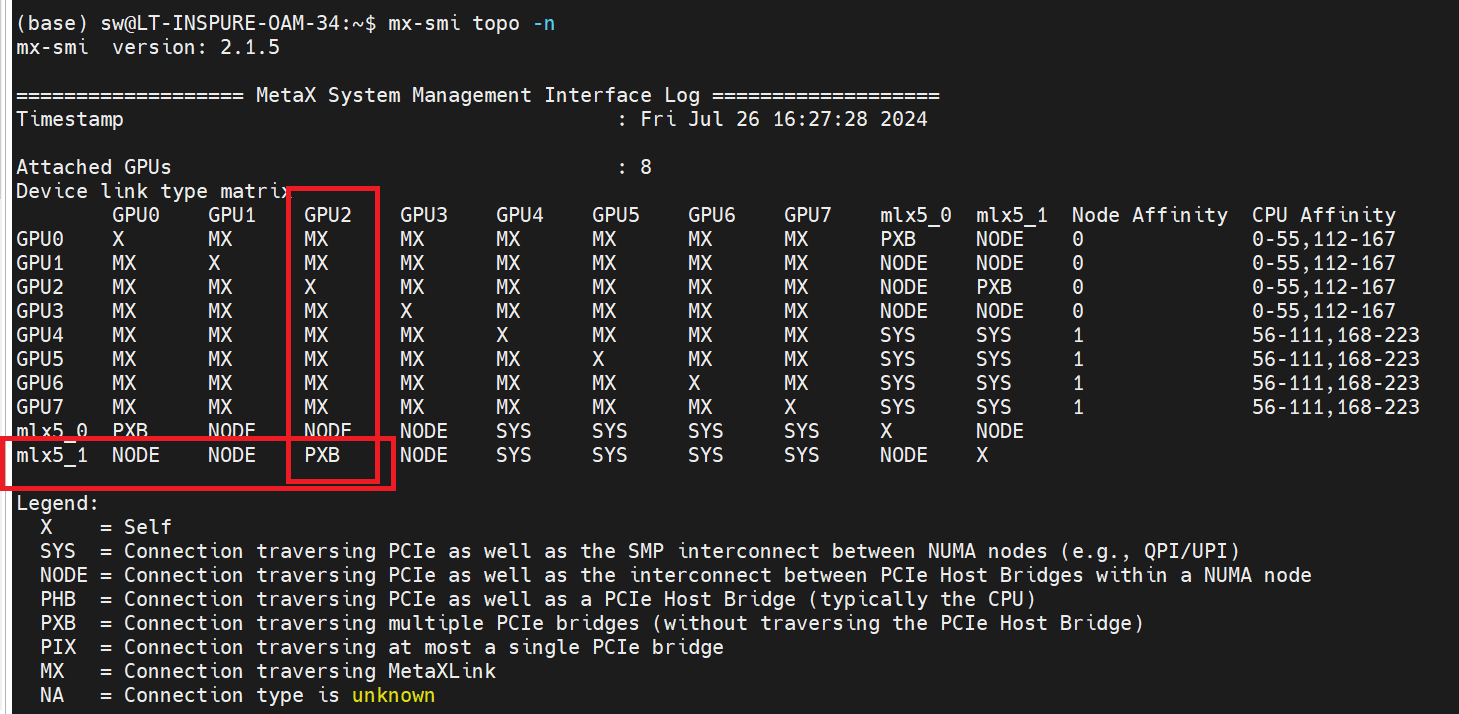
可以用命令mx-smi topo -n 查看距离网卡较近的GPU,如图mlx5_1距离GPU2近,所以参数为 -d mlx5_1 --use_maca=2
距离:PIX 最近,PXB次之,NODE,SYS按照顺序越来越远
--run_infinitely : 测试一直进行,除非手动杀掉进程
-p 10000 : 测试使用的通信端口为10000
在C588的硬件环境下,use_maca设置需要按照双倍数进行调整,否则会导致ib_write_bw的测试结果偏低。
设置方法如下,如果mlx5_1对应距离最近的是GPU1,此时设置user_maca的时候不能指定为1,需要指定为2。相同的,如果说用mlx5_10做ib_write_bw的话,对应最近的是GPU7,但是还是同样588的原因,设置use_maca的时候需要设置为14。
MXRDMA网卡测试
MXRDMA网卡是C600/N300上自带的Metax ETH网口,遵循RoCE V2协议。该网口的测试需添加特殊参数,请按照下述示例进行测试。
两卡测试示例(两卡可以为单机两卡,或者两机两卡,注意网口的选择,示例参数是必需的):
export MACA_PATH=/opt/maca
export LD_LIBRARY_PATH=/opt/maca/lib:/opt/maca/mxrdma/lib:$LD_LIBRARY_PATH
# server端执行命令:
/opt/maca/samples/mccl_tests/ib_perf/tests/ib_write_bw -d metax_rdma_0 --disable_pcie_relaxed --use_old_post_send --use_maca=0 -a -n 10 -m 4096
# client端执行命令
/opt/maca/samples/mccl_tests/ib_perf/tests/ib_write_bw -d metax_rdma_1 --disable_pcie_relaxed --use_old_post_send --use_maca=1 -a -n 10 -m 4096 10.2.187.44
性能测试截图
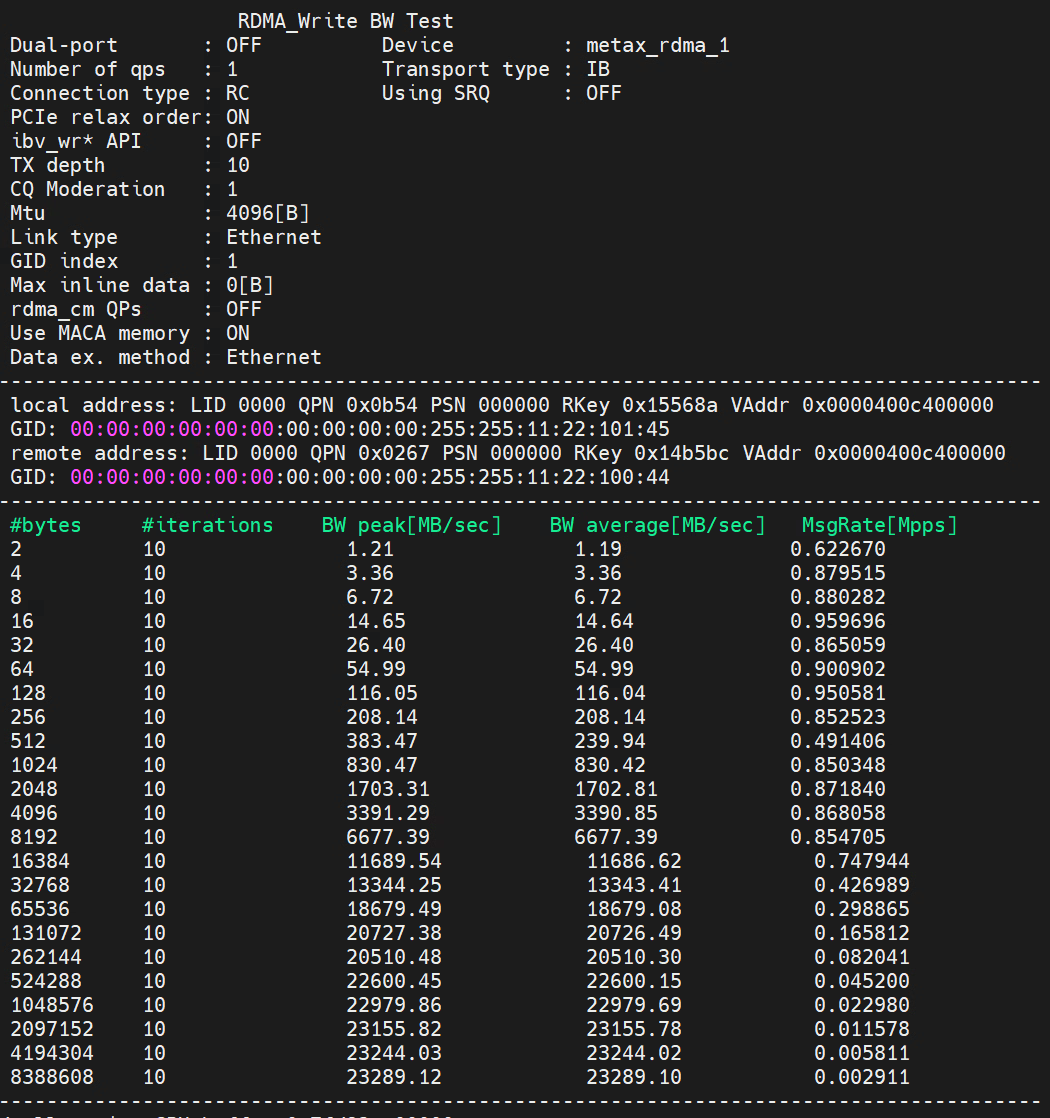
参数解释
-a : 使用测试size为2~2^23 Bytes
-b: 测试双向带宽,不加-b仅测试单向带宽
-d: metax_rdma_0 表示用网卡设备metax_rdma_0来进行测试,其他网卡设备名字可通过ibstat命令查看
-F : 表示测试开启CPU高频模式
-x 1 : RoCE网卡测试需要,-x 3表示使用RoCE 的gid index为3
--use_maca=0 : 表示用gpu0 的hbm来做网卡metax_rdma_0的带宽测试,请确保使用相同的索引。
不使用--use_maca表示用cpu memory来做测试。
--run_infinitely :测试一直进行,除非手动杀掉进程
-p 10000 :测试使用的通信端口为10000
--disable-pcie-relaxed : 禁用PCIe relaxed ordering
--use_old_post_send: 使用旧有的ibv_post_send进行发送,而不是新的(ibv_wr_*)接口
-n 10 : 每一种数据大小的重复测试的次数
网卡绑定numa测试
不使用--use_maca的情况下,网卡用cpu memory来做测试,这是会收到CPU numa特性的影响,导致性能不稳定,需要绑定测试进程到最近的CPU numa上,具体步骤如下:
执行mx-smi topo -n 获取机器topo,找到网卡所属的numa。
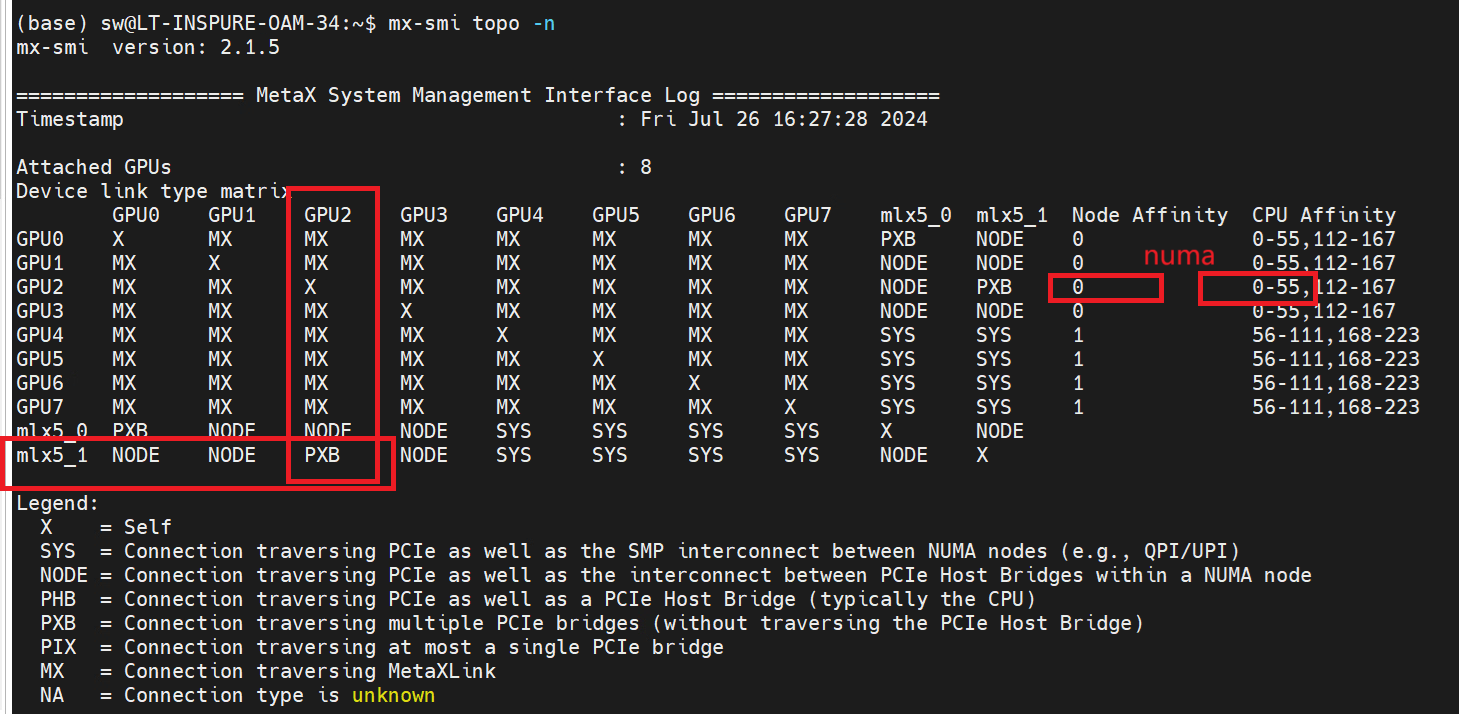
如上图,mlx5_1,离GPU2最近为PIX,GPU2数据numa 0,对应CPU核心0-55。那么mlx5_1属于numa 0。所以不使用--use_maca的的测试脚本绑定numa操作为使用taskset -c 0-55 来绑核心。不同机器测试绑定numa的情况不一样,都要用上面的方法匹配一下。
#server端执行命令:
taskset -c 0-55 /opt/maca/samples/mccl_tests/ib_perf/tests/ib_write_bw -a -F --report_gbits -d mlx5_0
#client端执行命令:
taskset -c 0-55 /opt/maca/samples/mccl_tests/ib_perf/tests/ib_write_bw  -a -F --report_gbits -d mlx5_1 10.2.122.226
异常问题
libpci动态库问题
如执行ib perf test后,报libpci.so找不到错误(报错如下图),则需在本地安装pci组件。
安装命令:sudo apt-get install libpci-dev

non-GPLONLY接口报错
在maca机器上多机测试RDMA网卡通信不成功,dmesg有如下日志:
[Mon Aug  3 20:12:59 2026] MXCD.PEER.INFO Try to initialize peer memory client support
[Mon Aug  3 20:12:59 2026] failing symbol_get of non-GPLONLY symbol ib_register_peer_memory_client.
[Mon Aug  3 20:12:59 2026] failing symbol_get of non-GPLONLY symbol ib_register_peer_memory_client.
[Mon Aug  3 20:12:59 2026] failing symbol_get of non-GPLONLY symbol ib_unregister_peer_memory_client.
[Mon Aug  3 20:12:59 2026] failing symbol_get of non-GPLONLY symbol ib_unregister_peer_memory_client.
[Mon Aug  3 20:12:59 2026] MXCD.PEER.INFO Peer memory client interface was not detected
原因:
peer mem注册不上,是因为debian的发行版内核引入了限制——只支持GPL only的接口,而IB网卡驱动(drivers/infiniband/core/peer_mem.c)导出的接口函数是non-GPL类型,IB网卡驱动和debian发行版linux内核的适配有问题,已知linux内核 4.19.0-amd64、5.10.0-0.deb10.28-amd64有此问题。
修复方案:
方案一:回退kernel版本(已验证linux-image-5.10.0-0.deb10.24没问题)。
方案二:修改 metax driver加载方法,特殊指定ib_reg_addr,ib_unreg_addr的地址。
手动加载metax方法
sudo rmmod metax

sudo cat /proc/kallsyms |grep peer_memory_client

ffff8000015f7074 T ib_register_peer_memory_client
ffff8000015f7274 T ib_unregister_peer_memory_client

sudo modprobe metax ib_reg_addr=0xffff8000015f7074  ib_unreg_addr=0xffff8000015f7274
以root用户执行如下脚本:
#!/bin/bash
rmmod metax
ib_register_peer=$(cat /proc/kallsyms |grep "T ib_register_peer_memory_client" | awk '{print $1}')
ib_unregister_peer=$(cat /proc/kallsyms | grep "T ib_unregister_peer_memory_client" | awk '{print $1}')

ib_reg_addr="0x${ib_register_peer}"
ib_unreg_addr="0x${ib_unregister_peer}"

modprobe metax ib_reg_addr=${ib_reg_addr} ib_unreg_addr=${ib_unreg_addr}
MCCL单机测试
单机测试需要保证所有测试服务器的GPU都是空闲状态,不需要IB/RoCE网卡。
1、cd /opt/maca/samples/mccl_tests/perf
2、sudo bash mccl.sh(默认测试单机4卡 all reduce)
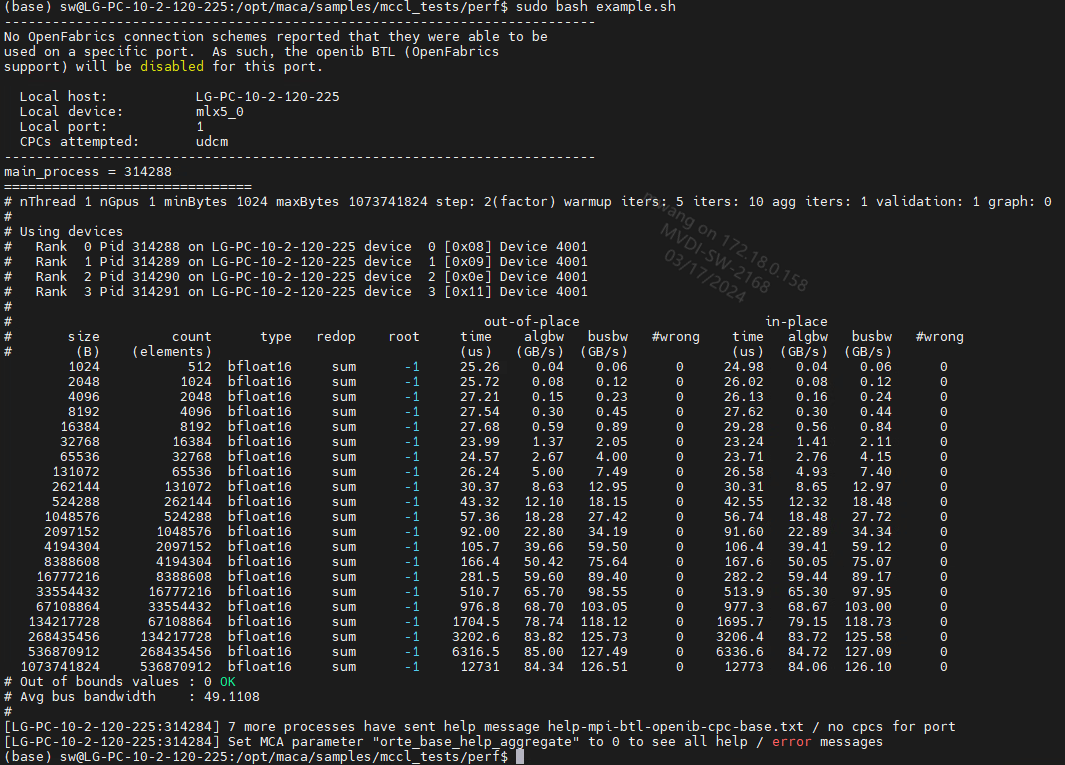
3、sudo bash mccl.sh 8(测试单机8卡 all reduce)
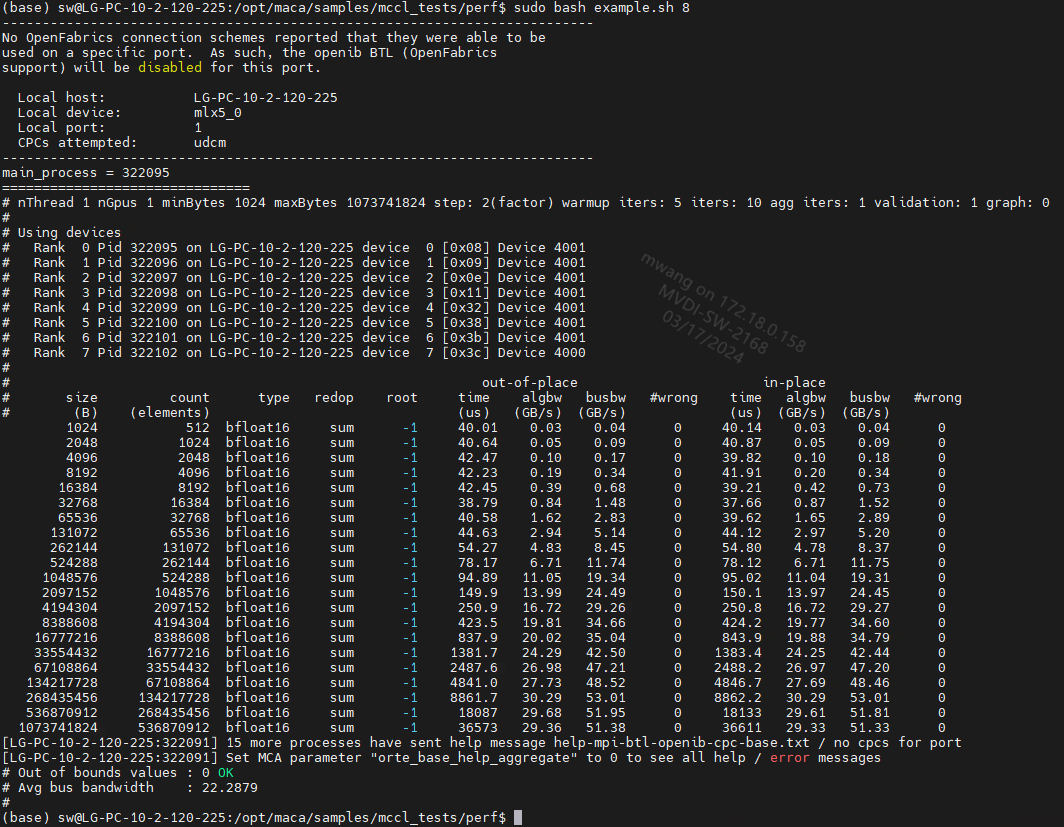
如果单机测试mccl bench的结果和上述截图差异较大,说明单机环境有问题。
MCCL多机测试
多机RDMA通信测试脚本可参考/opt/maca/samples/mccl_tests/perf/cluster.sh(需要安装maca),修改其中的服务器ip地址和可用网卡端口信息后,可直接使用。另外像C500X等超节点,在超节点规模内的多机通信除了RDMA网络外,还可以只通过MetaxLink进行通信(需参考dragonfly.sh进行测试),测试时注意区分。
测试多机RDMA通信时,有如下注意事项:
1、需要确认机器使用的是IB网络还是RoCEv2网络,并确认可用计算网口。
2、需要确认测试机器之间所有的IB/RoCE网卡是互通的,测试方法参考上面的“IB/RoCE网卡测试”,确保所有网卡和交换机是正常的,尤其需要关注“查看网卡拓扑”小节,MCCL多机性能和网卡拓扑及单机P2P状态强相关。
3、测试需要保证用户对执行脚本的工作目录拥有可读写权限,因为测试会生成中间数据。
4、需要保证所有参与测试的服务器可免密互访,已安装maca包,且GPU都是空闲状态。
5、MCCL默认使用GDR模式进行网络通信,在特定情况下如需关闭GDR而使用CPU内存进行RDMA传输,可通过环境变量MCCL_NET_GDR_LEVEL=LOC来关闭GDR,常规情况下关闭GDR,网络性能会变差。
服务器免密互访配置
以ubuntu为例,免密访问配置举例如下:
- 检查所有机器有没有ssh key,如没有则生成ssh key
bash
ls ~/.ssh/id_rsa.pub || ssh-keygen -N '' -f ~/.ssh/id_rsa- 配置运行测试的本地服务器可以免密登录其他服务器,remote_ip1代表对端服务器ip地址
bash
ssh-keyscan -H $remote_ip1 >> ~/.ssh/known_hosts
ssh-copy-id -f $username@$remote_ip1- 运行多机测试只能在配置过免密的服务器上进行,如需在对端服务器运行,则需要在对端服务器进行相应免密配置。
MCCL多机测试脚本范例
可参考/opt/maca/samples/mccl_tests/perf/cluster.sh,亦可参照下述范例。
是否添加环境变量MCCL_SOCKET_IFNAME和网卡配置强相关,默认场景,MCCL会自动搜索对应网口,如只有一个socket网口,可不手动设置,如有多个,且命名等配置不统一,需指定;或者为防止出现不可预知的混乱问题,可以直接指定。
#!/bin/bash
MACA_PATH=/opt/maca
LIB_PATH_ENV="-x LD_LIBRARY_PATH=${MACA_PATH}/lib:/${MACA_PATH}/ompi/lib"

CARD_NUM=16 #测试GPU数量
HOST_IP=10.2.122.225:8,10.2.122.226:8 #IP:GPU数量
IP_MASK=10.2.122.0/24 #服务器ip地址对应的掩码
IB_PORT=mlx5_0,mlx5_2 #用做计算RDMA通信的IB/RoCE网卡
SOCKET_NIC=enP3s48f0,enP3s48f1 #用做socket通信的网卡,ifconfig确认好网卡名字,不同机器的网卡名不同可以用逗号隔开
BENCH_NAME=${MACA_PATH}/samples/mccl_tests/perf/tests/all_reduce_perf

MCCL_ENV="${MCCL_ENV} -x MCCL_SOCKET_IFNAME=${SOCKET_NIC} -x MCCL_IB_HCA=${IB_PORT} -x MCCL_P2P_LEVEL=SYS ${LIB_PATH_ENV}"
MPI_ENV="${MPI_ENV} -mca pml ^ucx -mca btl ^openib -mca osc ^ucx -mca btl_tcp_if_include ${IP_MASK} -mca oob_tcp_if_include ${IP_MASK}"

${MACA_PATH}/ompi/bin/mpirun -n ${CARD_NUM} -host ${HOST_IP} ${MPI_ENV} ${MCCL_ENV} ${BENCH_NAME} -b 1K -e 1G -f 2
RoCEv2网络测试添加gid index参数
该参数MCCL已默认对应选择为ipv4,RoCEv2。详细信息可参考如下描述:
需要先执行命令show_gids查看网卡的gid信息,确认RoCEv2网络使用的gid号:
如图:执行show_gids可以查看到网卡的gid信息。
gid VER v1表示RoCEv1,VER v2表示RoCEv2。
gid一般有两种,分别使用ipv6,ipv4来标识。单层交换机可以采用ipv6或者ipv4标识的gid,多层交换机一般采用ipv4,这样可以在交换机上面添加路由规则,支持多层交换机。所以按照RoCEv2 ipv4检索到的index为3,按照RoCEv2 ipv6检索到的index则为1。
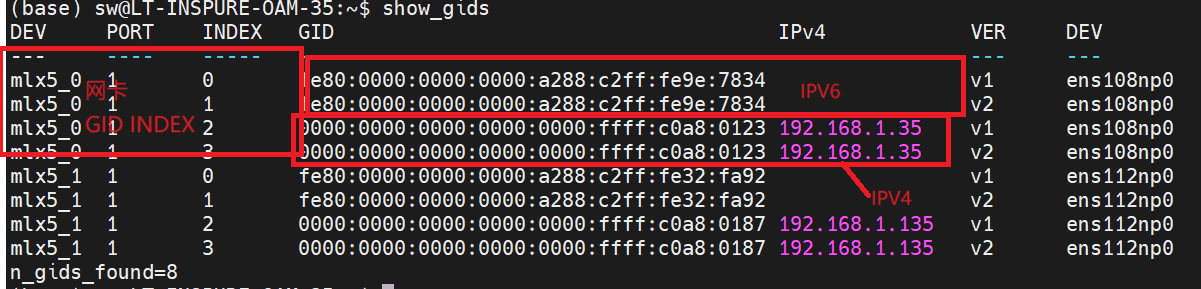
注意:按照本指南的配置,网卡的GID INDEX列应该是有0,1,2,3,集群所有机器都应该是这样。如果出现了4,5,请务必检查配置ipv6.method 是否配置成ignore,如果GID INDEX不一致的话会影响集群功能和稳定性。
上述RoCEv2网络的测试脚本如下:
参数 -x MCCL_IB_GID_INDEX=3 标识使用index为3 的gid 流量走ipv4
参数 -x MCCL_IB_GID_INDEX=1 标识使用index为1 的gid 流量走ipv6
#!/bin/bash
MACA_PATH=/opt/maca
LIB_PATH_ENV="-x LD_LIBRARY_PATH=${MACA_PATH}/lib:/${MACA_PATH}/ompi/lib"

CARD_NUM=16 #测试GPU数量
HOST_IP=10.2.122.225:8,10.2.122.226:8 #IP:GPU数量
IP_MASK=10.2.122.0/24 #服务器ip地址对应的掩码
IB_PORT=mlx5_0,mlx5_2 #用做计算RDMA通信的IB/RoCE网卡
SOCKET_NIC=enP3s48f0,enP3s48f1 #用做socket通信的网卡,ifconfig确认好网卡名字,不同机器的网卡名不同可以用逗号隔开
BENCH_NAME=${MACA_PATH}/samples/mccl_tests/perf/tests/all_reduce_perf

#/*************RoCE参数*************/
#RoCE网络需要添加
GID_INDEX=3 #RDMA 网卡使用的RoCE gid index, 3对应ipv4,1对应ipv6
MCCL_ENV="${MCCL_ENV} -x MCCL_IB_GID_INDEX=${GID_INDEX}"
#/*************RoCE参数*************/

MCCL_ENV="${MCCL_ENV} -x MCCL_SOCKET_IFNAME=${SOCKET_NIC} -x MCCL_IB_HCA=${IB_PORT} -x MCCL_P2P_LEVEL=SYS ${LIB_PATH_ENV}"
MPI_ENV="${MPI_ENV} -mca pml ^ucx -mca btl ^openib -mca osc ^ucx -mca btl_tcp_if_include ${IP_MASK} -mca oob_tcp_if_include ${IP_MASK}"

${MACA_PATH}/ompi/bin/mpirun -n ${CARD_NUM} -host ${HOST_IP} ${MPI_ENV} ${MCCL_ENV} ${BENCH_NAME} -b 1K -e 1G -f 2
MCCL测试脚本参数解释
- mpirun -n
脚本是使用openmpi的mpirun 启动测试进程,-n 表示启动的进程数量,一般一个进程一个gpu。
- -host 10.2.122.225:8,10.2.122.226:8
表示在机器10.2.122.225最多启动8张GPU,10.2.122.226最多启动8张GPU。
- -mca pml ^ucx -mca btl ^openib -mca osc ^ucx
关闭openmpi的一些特性,防止其影响性能。
- -mca btl_tcp_if_include
mpi会选择本机的ip地址对应的网卡进行mpi通信,例如下图
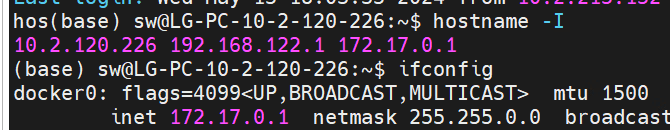
当一个机器上存在多个ip地址,可能会出现mpi通信失败的问题,这时候需要btl_tcp_if_include 指定通信用的网段,这样只会使用该网段内的网卡进行通信。
-mca btl_tcp_if_include 10.2.122.0/24 以子网掩码的方式表示网段,范围为10.2.122.0~10.2.122.255.
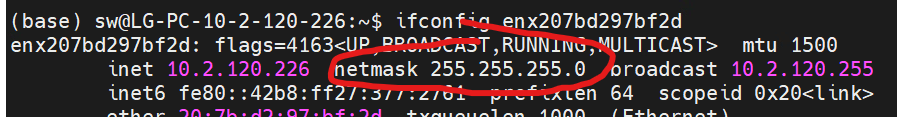
/24子网掩码实际就是二进制:11111111.11111111.11111111.00000000,其中数值1有24位长度,所以:/24位的子网掩码就是:255.255.255.0,和下图10.2.122.226的子网掩码相匹配。
当有多个网段存在是可以叠加,以10.2.122.0/24,10.2.111.0/24为例,有3种叠加方式
直接把所有网段都列出来-mca btl_tcp_if_include 10.2.122.0/24,10.2.111.0/24
减少子网掩码长度使网段扩容-mca btl_tcp_if_include 10.2.0.0/16
使用网卡名替代网段-mca btl_tcp_if_include enx*
MCCL_IB_HCA
用来控制使用那些网卡来进行MCCL通信
MCCL_IB_HCA=mlx5 : 使用所有mlx5_**代表的网卡
MCCL_IB_HCA=^mlx5_1,mlx5_4 : 不使用 mlx5_1和 mlx5_4
MCCL_IB_HCA=mlx5_1,mlx5_4 : 只使用 mlx5_1和 mlx5_4
- MCCL_IB_GID_INDEX=3
标识使用index为3 的gid,不同的集群gid值会不一样,IB网络不需要使用,RoCE网络需要用show_gids命令确认一下。
- MCCL_P2P_LEVEL=SYS
用来控制GPU的P2P最大通信路径,路径超过该LEVEL就会关闭P2P功能。
不同值对应的含义如下。
LOC : 强制关闭PCIe P2P
MetaxLink : 当路径上有MetaxLink时才启用P2P
PIX : 当GPU位于同一PCIe switch下时,启用P2P
PXB : 当GPU位于同一PCIe RC下时,启用P2P
PHB :当GPU位于同一numa节点下时,启用P2P
SYS : 当GPU位于不同numa节点,跨UPI通信,也启用P2P
注意路径长度递增,即 MCCL_P2P_LEVEL=SYS 对于PHB、PXB、PIX等都会启用P2P, MCCL_P2P_LEVEL=PXB对于SYS、PHB不会启用P2P。
- MCCL_NET_GDR_LEVEL=SYS
用来控制 NIC 和 GPU 通信是否使用 GPU Direct RDMA,路径控制同 MCCL_P2P_LEVEL。
- MCCL_CROSS_NIC=1
用来控制MCCL单个channel的流量会不会跨网卡。
MCCL_CROSS_NIC=0:表示流量不会跨网卡,从同一个网卡进去,再出来
MCCL_CROSS_NIC=1:表示流量在多网卡的情况下,会跨网卡,从一个网卡进去,另一个网卡出来
MCCL_CROSS_NIC=2:(默认值)表示由MCCL代码决定流量要不要跨网卡
FORCE_ACTIVE_WAIT=1 为提升UMD性能的配,改中断为polling。
MX_TRACER_ENABLED_MCPTI=ON 可以在测试结果中展示gpu kernel的执行时间
-b 1K -e 1G -f 2表示测试数据为1K Bytes ~ 1G Bytes,step 按照2倍递增。
GIN相关的测试需要增加-R 2 -D 3选项。目前GIN只支持alltoall_perf。
R5300G6 x86 服务器common topo测试结果如下:
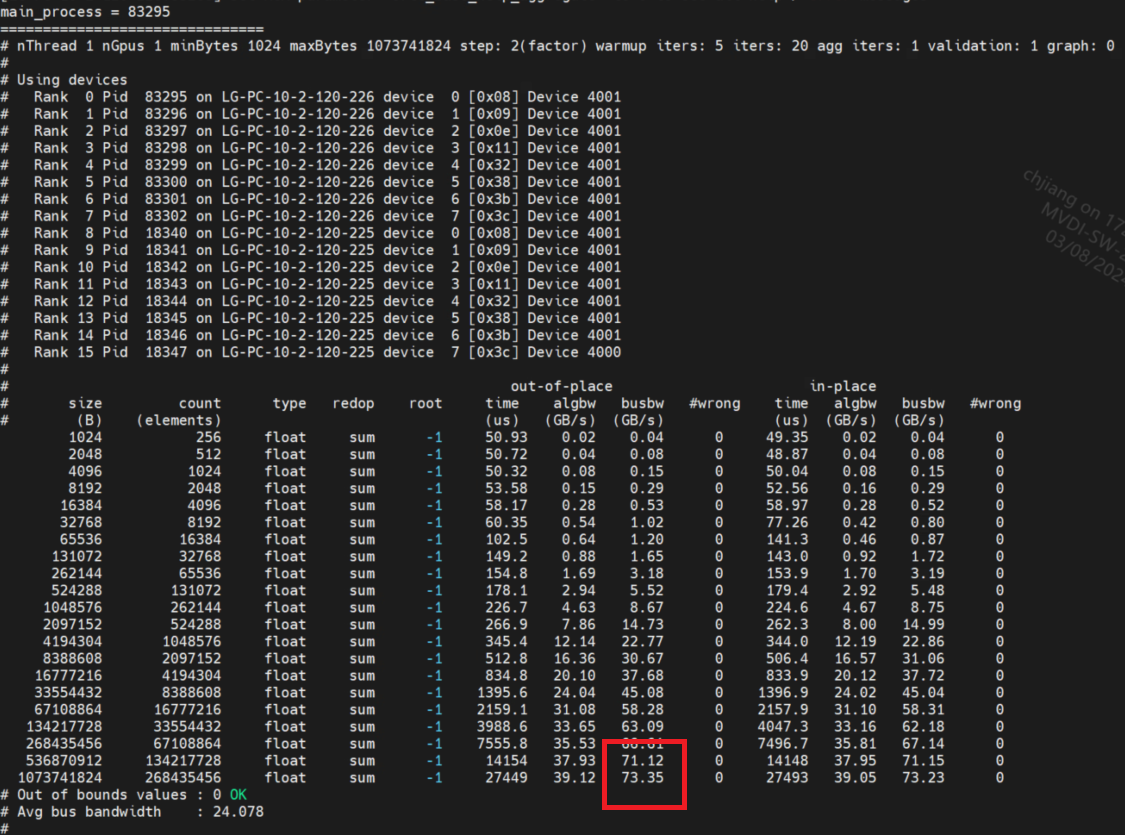
如果多机测试mccl bench的结果(红圈处的带宽数值)和上述截图差异较大,说明网络环境有问题。
topo:补充更多的机器topo 性能
ARM平台测试
MaxPayload配置
PCIe P2P性能问题需要配置MaxPayload>=256Byte。
PCIe的max payload配置会影响PCIe的带宽,对于通信库来说,主要影响带网卡和GPU之 间的带宽。目如果PCIe max payload为128B,则数据在超过128M之后带宽将下降。此时调整max payload为256B,带宽将继续上升接近理论带宽。
查看PCIe设备的max payload命令如下:
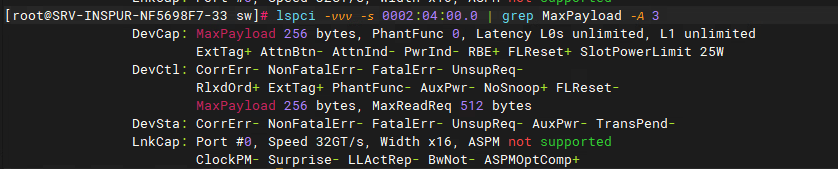
如果max payload不为256B,建议修改max payload。不同服务器平台修改的方式不一样,通常是进入bios进行修改。如果找不到修改方法,建议咨询服务器厂商。
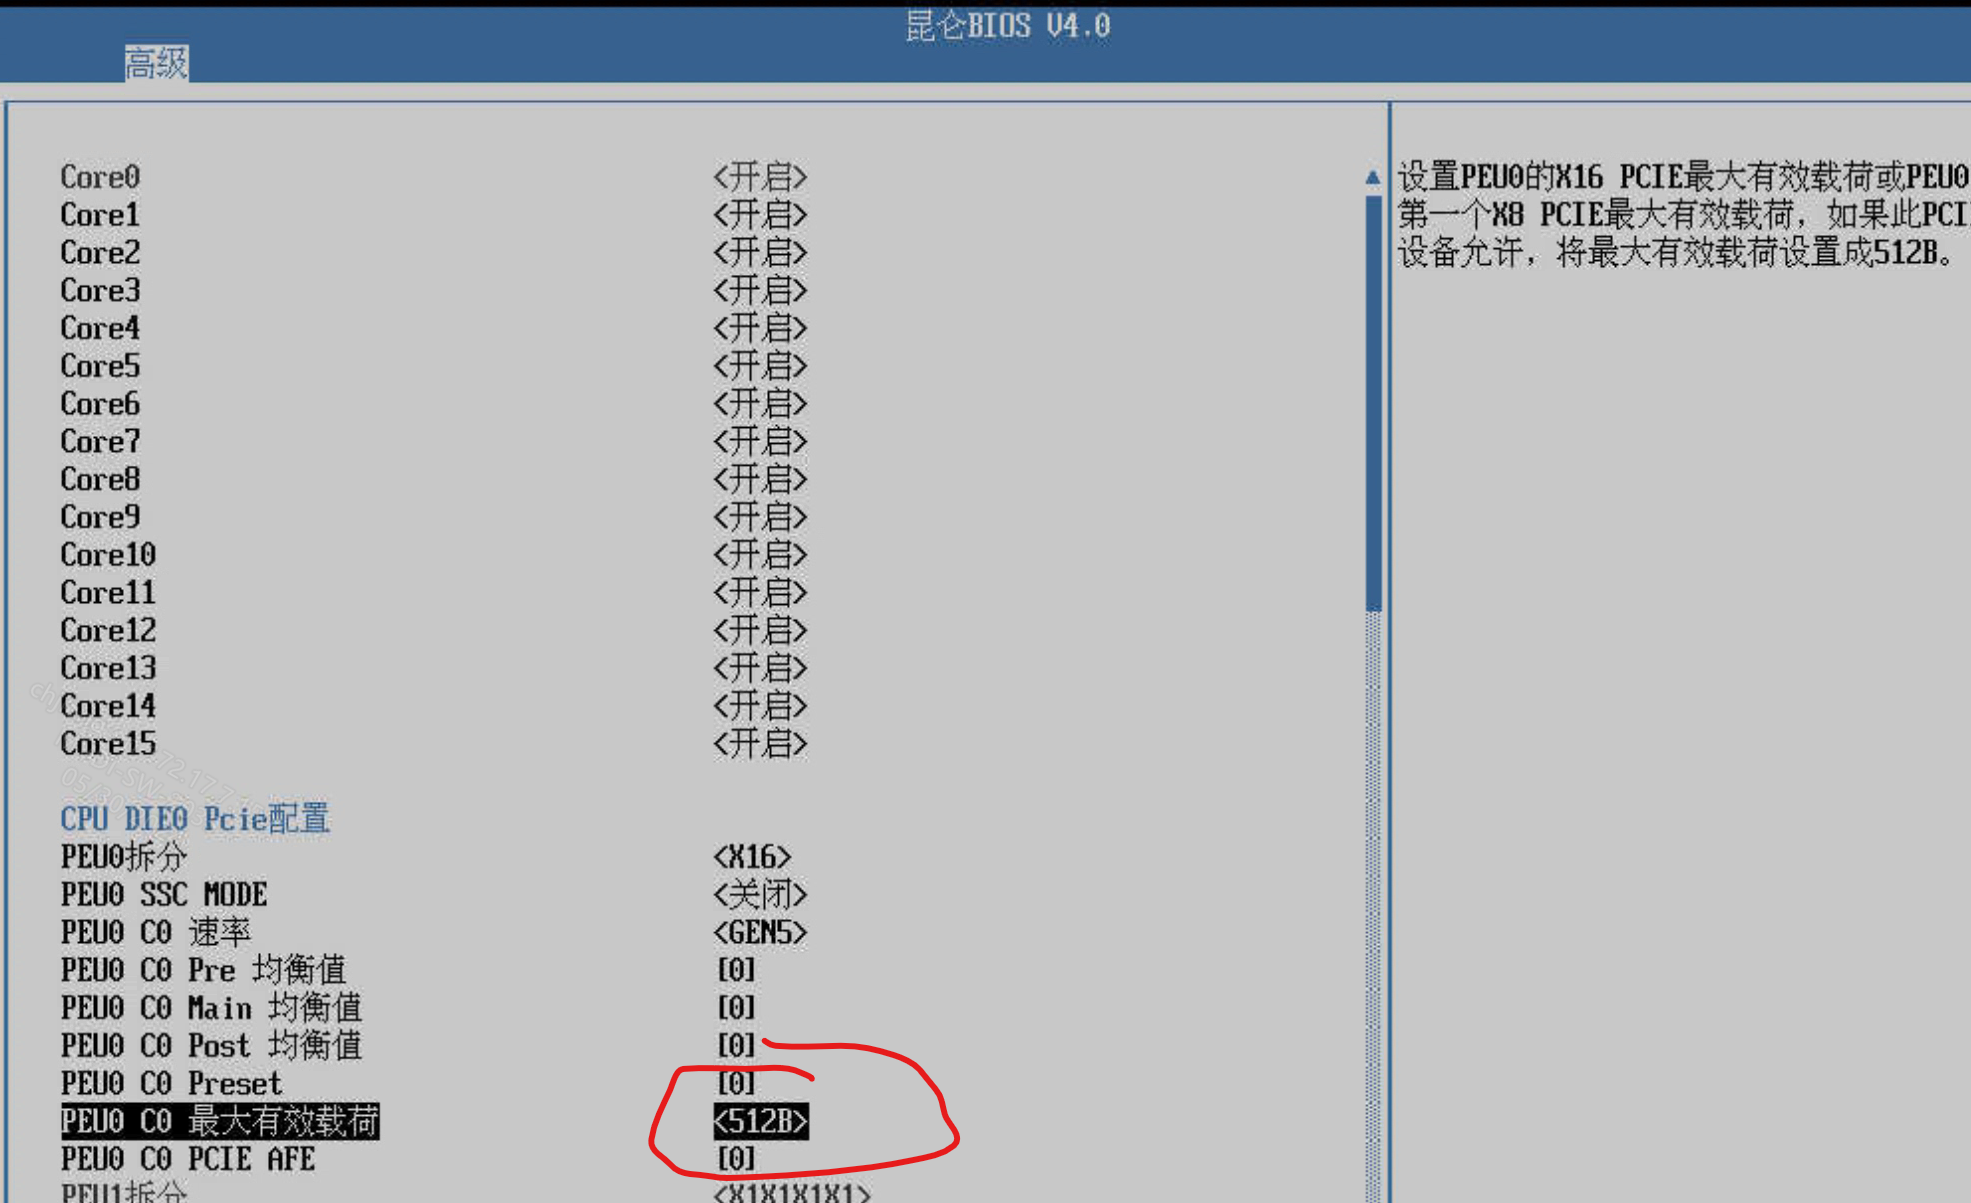
举例:ARM 同泰怡服务器的PCIe MaxPayload修改
位于bios CPU配置选项中,PEU的最大有效载荷,如果小于256B的话,需要修改为256B。重启后,需要用上面的方式确认MaxPayload是否修改成功。
numa核心绑定
当使用飞腾等ARM平台及海光CPU平台时,通信库性能受numa特性影响较大,需要绑核来进行测试。
首先通过命令mx-smi topo -m查看离GPU最近的numa核心
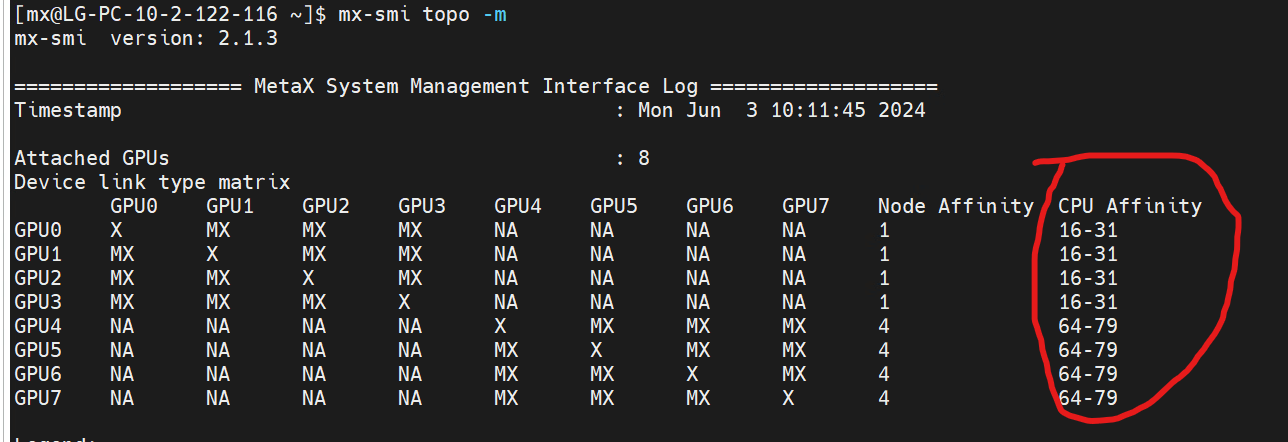
可以看到,GPU0、1、2、3离numa node1比较近,对应CPU核心为16-31,GPU4、5、6、7为numa node4,对应CPU核心为64-79。
编写绑核配置文件myrank,文件表示有两台机器10.2.122.115,10.2.122.116,每台机器都有8张GPU,GPU0~3绑定在CPU16-31,GPU4-7绑定在CPU64-79。rank编号随着机器递增。
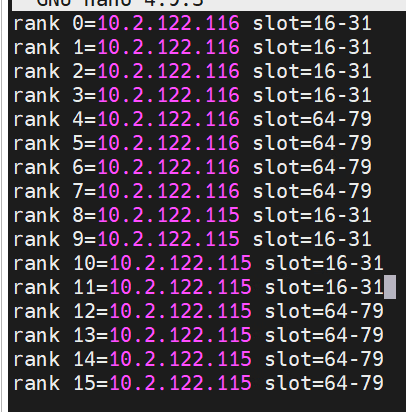
绑核的测试脚本举例如下,使用--rankfile ./myrank 指定即可:
#!/bin/bash
MACA_PATH=/opt/maca
LIB_PATH_ENV="-x LD_LIBRARY_PATH=${MACA_PATH}/lib:/${MACA_PATH}/ompi/lib"

CARD_NUM=16 #测试GPU数量
HOST_IP=10.2.122.225:8,10.2.122.226:8 #IP:GPU数量
IP_MASK=10.2.122.0/24 #服务器ip地址对应的掩码
IB_PORT=mlx5_0,mlx5_2 #用做计算RDMA通信的IB/RoCE网卡
SOCKET_NIC=enP3s48f0,enP3s48f1 #用做socket通信的网卡,ifconfig确认好网卡名字,不同机器的网卡名不同可以用逗号隔开
BENCH_NAME=${MACA_PATH}/samples/mccl_tests/perf/tests/all_reduce_perf

#/*************ARM 绑核心参数*************/
NUMA_BIND_FILE=./myrank #arm 平台用来做numa绑定的文件
MPI_ENV="${MPI_ENV} --rankfile ${NUMA_BIND_FILE}"
#/*************ARM 绑核心参数*************/

MCCL_ENV="${MCCL_ENV} -x MCCL_SOCKET_IFNAME=${SOCKET_NIC} -x MCCL_IB_HCA=${IB_PORT} -x MCCL_P2P_LEVEL=SYS ${LIB_PATH_ENV}"
MPI_ENV="${MPI_ENV} -mca pml ^ucx -mca btl ^openib -mca osc ^ucx -mca btl_tcp_if_include ${IP_MASK} -mca oob_tcp_if_include ${IP_MASK}"

${MACA_PATH}/ompi/bin/mpirun -n ${CARD_NUM} -host ${HOST_IP} ${MPI_ENV} ${MCCL_ENV} ${BENCH_NAME} -b 1K -e 1G -f 2
网卡适配
环境适配
首先要检查网卡的MaxReadReq是不是大于256,大于256的话需要设置成256。

PCIe MaxReadReq设置
正常情况下沐曦的kmd会适配一批网卡型号,在kmd初始化阶段会设置白名单里的网卡MaxReadReq=256,但是如果网卡型号不在白名单里面,仍会出现MaxReadReq>256的情况,需要联系KMD同事张建进行适配,现有的项目可同通过下面的手段用setpci进行设置。
先setpci -s <bdf> CAP_EXP+8.w 获取当前值,然后setpci -s <bdf> CAP_EXP+8.w=1xxx, xxx保持原来的值不变
例如sudo setpci -s 33:00.0 CAP_EXP+8.w 获得4937,4对应MaxReadReq=2048
接下来执行sudo setpci -s 33:00.0 CAP_EXP+8.w=1937即可设置MaxReadReq=256
注意:计算网络用的每张网卡都需要配置MaxReadReq
| CAP_EXP+8.w | MaxReadReq |
|---|---|
| 5 | 4096 |
| 4 | 2048 |
| 3 | 1024 |
| 2 | 512 |
| 1 | 256 |
使能dmabuf
在使用RDMA网卡直接访问GPU显存的场景中,需要linux内核提供的peer memory或者dmabuf机制,来支持将GPU显存注册为网卡可以访问的MR。沐曦的一系列产品也不例外。
其中,peer meemory要求网卡厂商的驱动实现类似mellanox peer meemory的功能。
maca 驱动默认是支持peer meemory机制的,因此在RDMA网卡驱动也有相关实现的情况下,就可以直接跑测试,具体参考6.4章节的多机测试。
而dmabuf机制则是未来的技术演进趋势,因此MACA软件栈也在逐步支持它。
KMD版本要求
dmabuf的使用前提是操作系统的内核版本要足够新,满足网卡dmabuf的使用需求,具体可由网卡提供商来确定。
mellanox网卡测试通过的操作系统内核版本为5.15.0-58,2024年6月后的maca release版本才能支持
SDK版本要求
master SDK >= 20260806-1300
release SDK: 3.8.2,及其以后的release版本
ib_perf测试
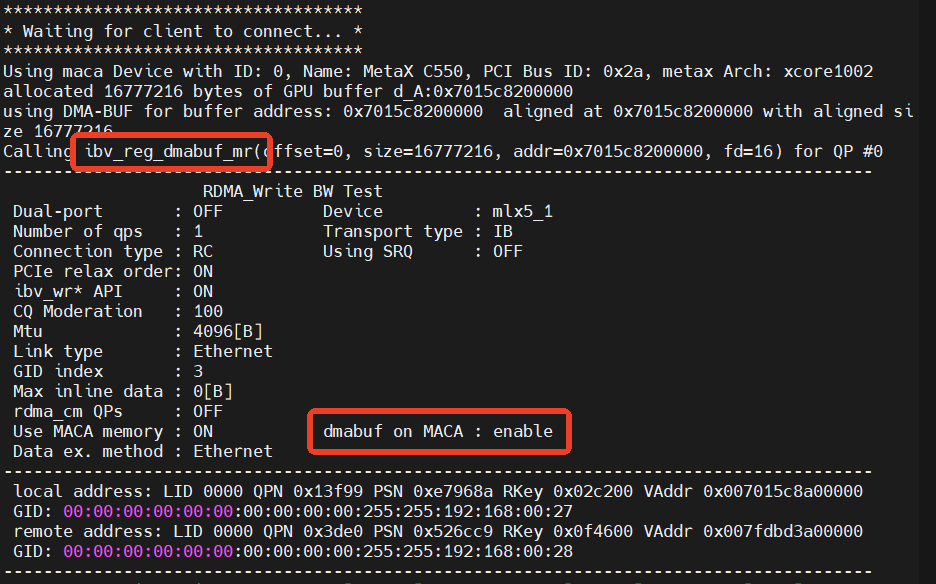
当在metax GPU上使用ib_write_bw进行测试时,使能dmabuf仅需添加 --use_maca_dmabuf 选项。
server端:/opt/maca/samples/mccl_tests/ib_perf/tests/ib_write_bw -d mlx5_0 -F --use_maca=0 -a --use_maca_dmabuf
client端:/opt/maca/samples/mccl_tests/ib_perf/tests/ib_write_bw -d mlx5_1 -F --use_maca=1 -a 10.2.122.226 --use_maca_dmabuf
注意:
选项“--use_maca_dmabuf”需要放置在“--use_maca=x”之后;
选项“--use_maca_dmabuf”需要放置命令行的最后,且不能有空格;
当使能dmabuf功能后,在测试输出中会出现如下图中红框所示的打印提示:
mccl perf测试
在多机mccl测试中,需要额外添加环境变量MCCL_DMABUF_ENABLE=1和MACA_NUMA_MEMORY_POLICY=1来使能dmabuf。
以IB网络为例的测试脚本如下:
#!/bin/bash
MACA_PATH=/opt/maca
LIB_PATH_ENV="-x LD_LIBRARY_PATH=${MACA_PATH}/lib:/${MACA_PATH}/ompi/lib"

CARD_NUM=16 #测试GPU数量
HOST_IP=10.2.122.225:8,10.2.122.226:8 #IP:GPU数量
IP_MASK=10.2.122.0/24 #服务器ip地址对应的掩码
IB_PORT=mlx5_0,mlx5_2 #用做计算RDMA通信的IB/RoCE网卡
SOCKET_NIC=enP3s48f0,enP3s48f1 #用做socket通信的网卡,ifconfig确认好网卡名字,不同机器的网卡名不同可以用逗号隔开
BENCH_NAME=${MACA_PATH}/samples/mccl_tests/perf/tests/all_reduce_perf

#/*************dmabuf 参数*************/
DMABUF_ENV="-x MACA_MXC_PATH=/opt/maca/lib/ -x MCCL_DMABUF_ENABLE=1 -x MACA_NUMA_MEMORY_POLICY=1"
MCCL_ENV="${MCCL_ENV} ${DMABUF_ENV}"
#/*************dmabuf 参数*************/

MCCL_ENV="${MCCL_ENV} -x MCCL_SOCKET_IFNAME=${SOCKET_NIC} -x MCCL_IB_HCA=${IB_PORT} -x MCCL_P2P_LEVEL=SYS ${LIB_PATH_ENV}"
MPI_ENV="${MPI_ENV} -mca pml ^ucx -mca btl ^openib -mca osc ^ucx -mca btl_tcp_if_include ${IP_MASK} -mca oob_tcp_if_include ${IP_MASK}"

${MACA_PATH}/ompi/bin/mpirun -n ${CARD_NUM} -host ${HOST_IP} ${MPI_ENV} ${MCCL_ENV} ${BENCH_NAME} -b 1K -e 1G -f 2
多机使用非RDMA协议通信
在一些特殊场景,如缺少RDMA设备或者定位问题的情况下,可以禁用RDMA协议,使用普通的Socket IP协议栈进行多机通信,此时性能会非常差。
1、如果RDMA网卡是IB模式或者没有RDMA网卡,Socket通信只能通过管理网卡传输。
需设置环境变量export MCCL_IB_DISABLE=1 和 export MCCL_SOCKET_IFNAME=每个机器的管理网口,管理网口可以通过ifconfig -a得到。
2、RDMA网卡是RocE模式,Socket通信可以通过RDMA网卡TCP/UDP模式传输,也可以通过管理网卡传输。
通过RDMA网卡传输,需export MCCL_IB_DISABLE=1;如需通过管理网卡传输,和上述小节1中的配置一致。
DeepEP单机测试
DeepEP包含三种算法:low latency、internode、intranode算法,internode和intranode算法默认只支持全互联拓扑,如C550,非全互联拓扑陆续支持中,具体可咨询通信库团队。low latency支持所有拓扑。
测试DeepEP前,请保证上述MCCL测试通过。
当前mxdeepep的相关测试需要依赖mxshmem,需要进行一些前置环境的准备工作。
基础环境搭建
确认主机的操作系统版本满足 Ubuntu 20及以上(Ubuntu18等以下版本可能无法work)
确认GPU和IB网卡的硬件状态
确认当前机器安装的RDMA网卡驱动(需要ofed驱动为23.10及以后,25.10及以前),如需要更新则采取以下安装步骤(或可参考本文档网卡驱动安装章节). 可使用下面命令检查当前版本:
ofed_info -s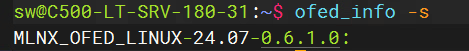
宿主机环境搭建
安装最新release 的MACA SDK master版本或者release-2.32及以后版本
安装MACA SDK对应的driver版本
确认当前python以及torch版本,目前仅支持python3.8, python3.10, python3.12和torch2.4,torch2.6,torch2.8,torch2.10的10种排列组合
安装python参考内部文档: https://repo.metax-tech.com/mirrors/index/wiki/python(推荐conda (miniForge))
安装MACA SDK对应的torch
需要同时安装,torch-2.xxxxxx.whl, flash_attn_xxx.whl

解压并pip install torch****以及flash_attn*****
安装numpy(1.24版本)
- pip install numpy==1.24
以上1,2,3步安装可参考内部文档
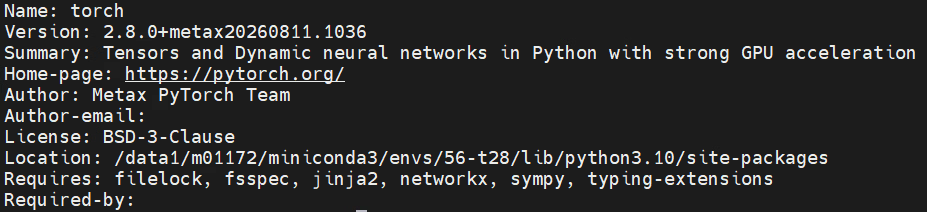
验证torch环境是否安装成功
- 输入pip show torch 查看torch的安装版本
输入python,进入交互界面
输入import torch,可以正常返回

docker环境搭建
- 获取容器压缩文件:
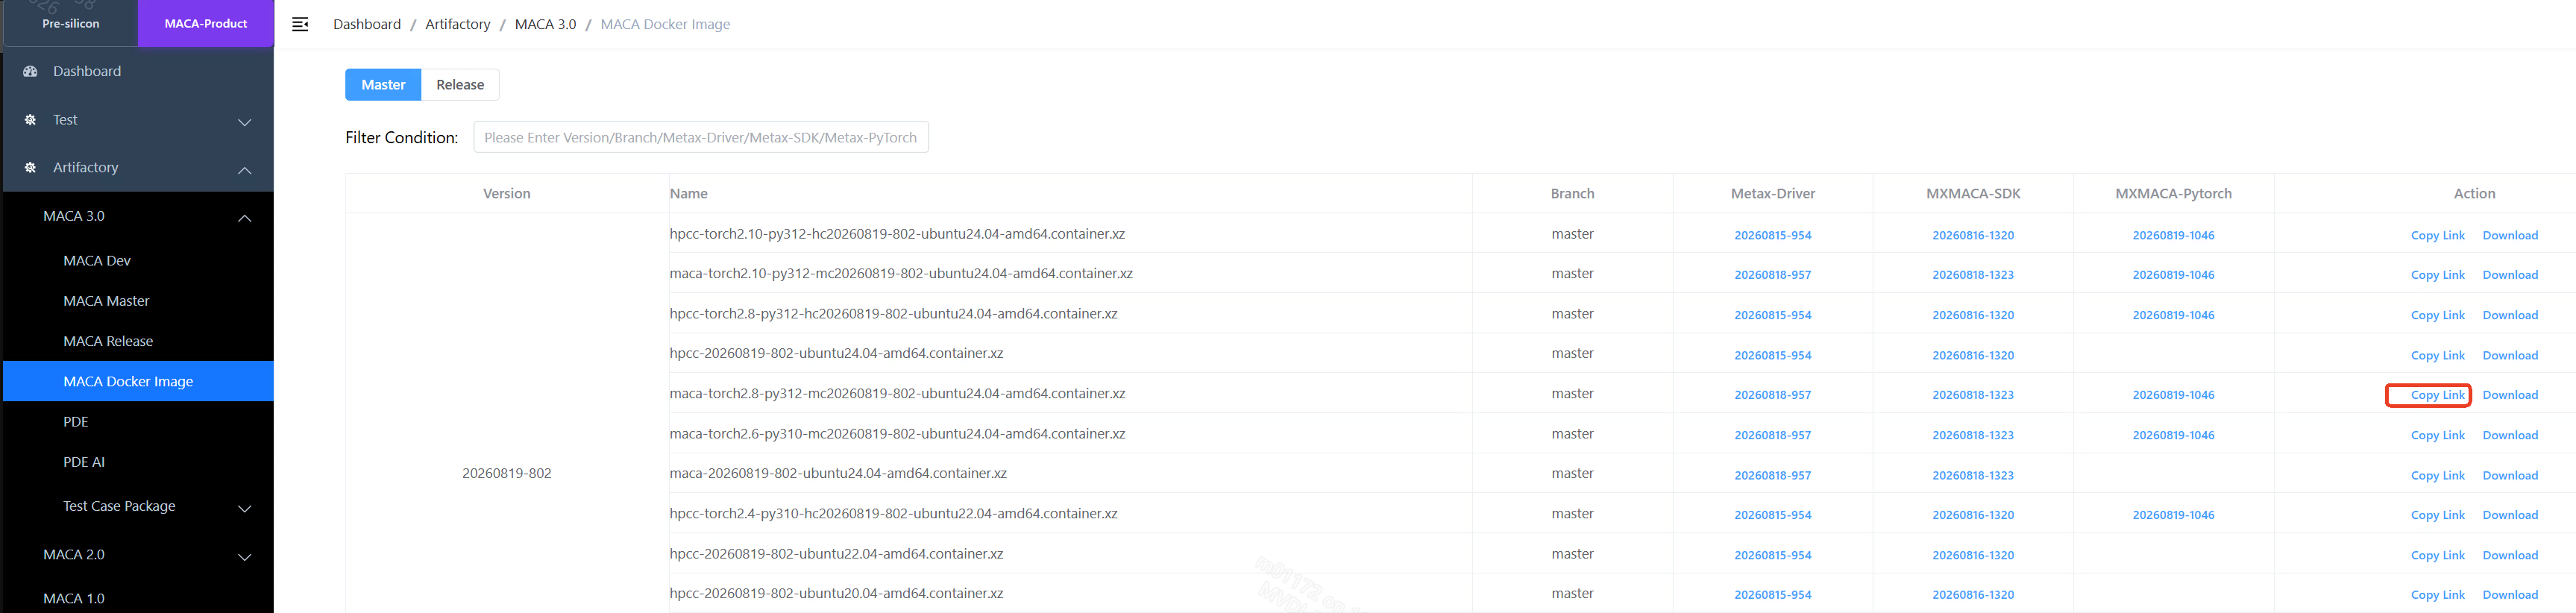
- 无需解压,使用 docker load -i maca-torch* 生成image

- 使用image构建对应的docker环境
docker run -itd --device=/dev/dri --device=/dev/mxcd --device=/dev/infiniband --group-add video --device=/dev/mem --network=host --security-opt seccomp=unconfined --security-opt apparmor=unconfined --shm-size '64gb' --ulimit memlock=-1 -v /pde_ai -w /workspace --name docker_name image_name /bin/bash
- 验证torch环境是否可用
进入docker中:docker exec -it 0820-test /bin/bash
输入pip show torch 查看torch的安装版本
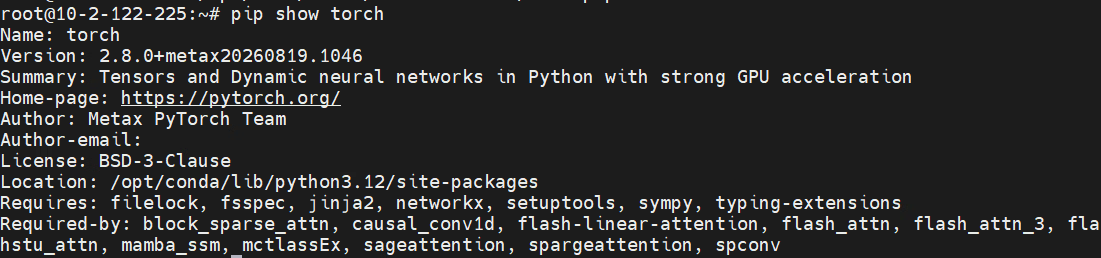
输入python,进入交互界面
输入import torch,可以正常返回
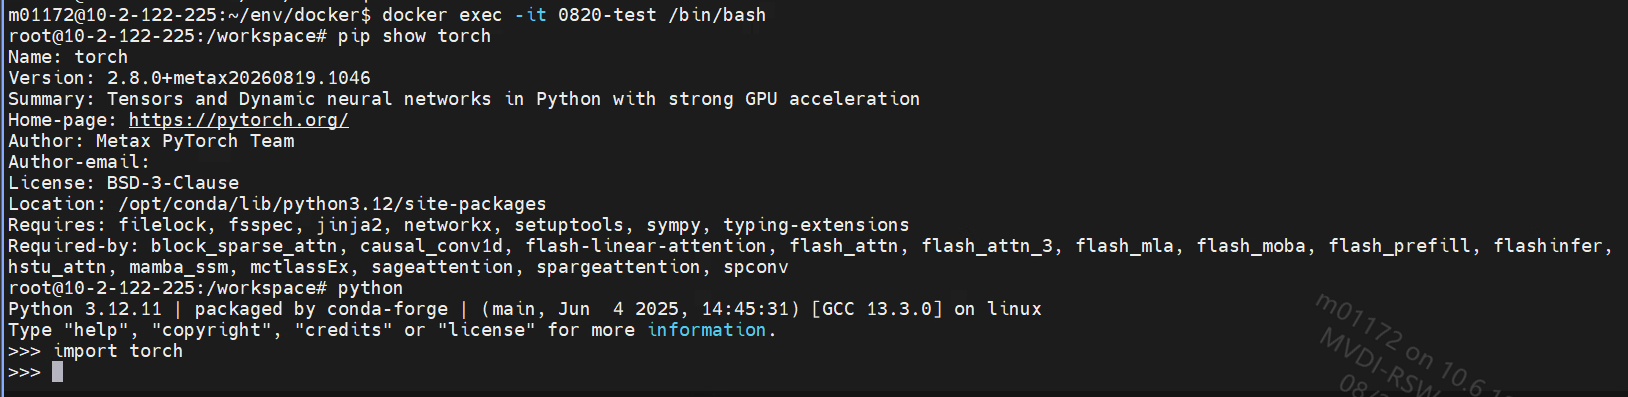
安装mxshmem和mxdeepep
| mxshmem获取 | Deepep获取 | |
|---|---|---|
| master(#20260510-924)或Release3.8.0及以后 | 自动安装至/opt/maca 无需手动安装 | SDK-PYTHON包 |
| master(#20251225-915)或Release3.6.0及以后 | 自动安装至/opt/maca 无需手动安装 | PYTORCH包 |
| master(#20251224-911)及Release3.5.x以前 | restricted包 | restricted包 |
master(#20260510-924)或Release3.8.0及以后版本
mxshmem随MACA SDK发布。 安装MACA SDK时自动安装至/opt/maca/lib, /opt/maca/include/mxshmem目录。
mxdeepep由PyTorch包改到SDK-PYTHON包发布。
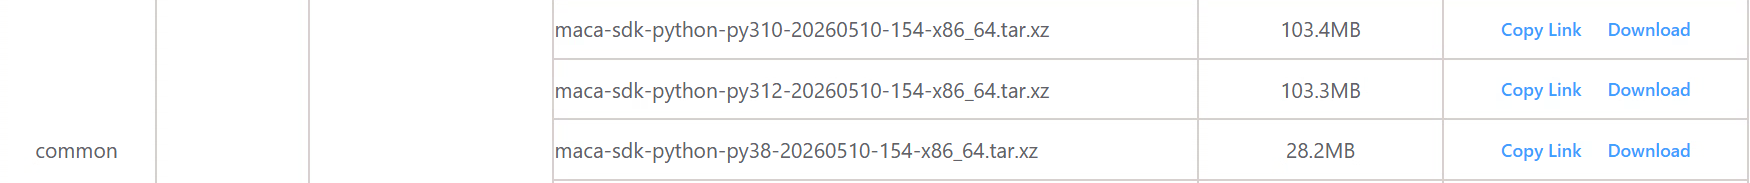
选择对应的python版本,解压后安装对应Pytorch版本的包
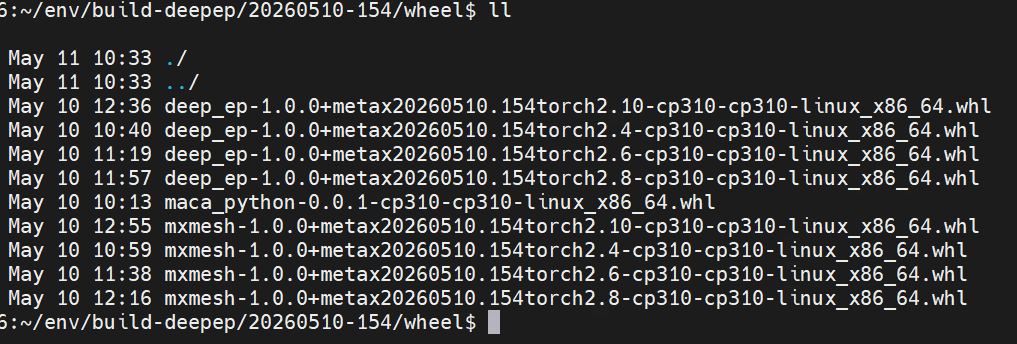
master(#20251225-915)或Release3.6.0及以后版本
mxshmem随MACA SDK发布。 安装MACA SDK时自动安装至/opt/maca/lib, /opt/maca/include/mxshmem目录。
mxdeepep随MACA PYTORCH发布。包含MACA PYTORCH的容器环境会自动安装mxdeepep, 也可通过VDI内部构建发布页面手动下载:(devopsportal.metax-internal.com)

注意与python及pytorch版本对应。
master(#20251224-911)及Release3.5.x以前版本
安装mxshmem
- 下载restricted包(VDI内 devopsportal.metax-internal.com )

解压并安装mxshmem安装包,安装包在解压目录的restricted/deb下
执行dpkg -i mxshmem_xxxxxxxx.deb
一般会安装到/opt/maca-$data/mxshmem目录下,需手动将该目录拷贝至/opt/maca下,减少后续环境变量配置;
安装deepep
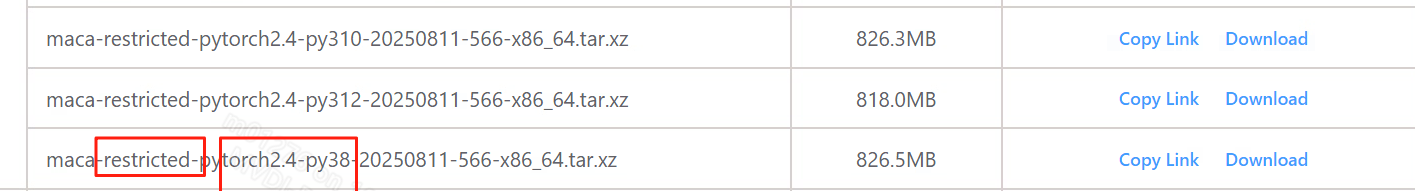
下载restricted的对应版本,注意与上述的(pytorch和python版本)对应
执行以下命令
pip install -i http://repo.metax-tech.com/r/pypi/simple --trusted-host repo.metax-tech.com deep_ep-1.0.0+a350ee3-cp310-cp310-linux_x86_64.whl环境变量设置
关于MXSHMEM和DEEPEP的环境变量详细描述请参考DeepEP环境变量指南 。
注意:
master(#20251224-911)及Release3.5.x以前版本 SHMEM环境变量以NVSHMEM开头。
master(#20251225-915)或Release3.6.0及以后版本 SHMEM环境变量以MXSHMEM开头。
如NVSHMEM_HCA_LIST 对应改为 MXSHMEM_HCA_LIST。
或者可以同时写两个兼容不同版本。
LowLatency
需要设置的环境变量
export MXSHMEM_HCA_LIST=mlx5_0:1,mlx5_1:1(可用的计算网卡网口)从Release 3.9.0 或 MASTER 20260817-271 SDK-PYTHON 开始默认 MXLink与IBGDA混合使用
若只使用IBGDA,需要额外设置环境变量,可降低hook模式的时延但带宽会有部分下降
export MXSHMEM_DISABLE_P2P=1Release 3.9.0 或 MASTER 20260817-271 SDK-PYTHON 之前的版本:
默认只使用IBGDA,不支持MXLink和IBGDA混合使用。
对于C500系列专家数超过256需要设置多专家支持, C600系列不能设置此环境变量否则会报错
export DEEPEP_MORE_EXPERTS=1Internode
internode测试需要使用网卡,需要配置:
export MXSHMEM_HCA_LIST=mlx5_0:1,mlx5_1:1(可用的计算网卡网口)从Release 3.9.0 或 MASTER 20260817-271 SDK-PYTHON 开始:
除网卡设置外 internode工作在不同的GPU上设置的环境变量有区别,详细设置如下:
#C600和N300
export MXDEEPEP_EXT_MAX_MXL_PEERS=4
export MACA_VISIBLE_DEVICES=0,4,8,12,1,5,9,13,6,2,10,14,7,3,11,15

#C600U
export MXDEEPEP_EXT_MAX_MXL_PEERS=8

#C500
export MXDEEPEP_EXT_MAX_MXL_PEERS=4

#C588
export MXDEEPEP_EXT_MAX_MXL_PEERS=2
export MACA_VISIBLE_DEVICES=0,1,6,7,10,11,14,15,3,2,5,4,9,8,13,12
Release 3.9.0 或 MASTER 20260817-271 SDK-PYTHON 之前版本:
除网卡设置外 在internode工作在不同的GPU上设置的环境变量有区别,具体如下
#C600和N300
export MACA_EXT_MXDEEPEP_MAX_NVL_PEERS=4
export MACA_VISIBLE_DEVICES=0,4,8,12,1,5,9,13,6,2,10,14,7,3,11,15
export MXSHMEM_DISABLE_P2P=0

#C600U
export MACA_EXT_MXDEEPEP_MAX_NVL_PEERS=8
export MXSHMEM_DISABLE_P2P=0

#C500
export MACA_EXT_MXDEEPEP_MAX_NVL_PEERS=4
export MXSHMEM_P2P_MAX_DISTANCE=pxb

#C588
export MACA_EXT_MXDEEPEP_MAX_NVL_PEERS=2
export MACA_VISIBLE_DEVICES=0,1,6,7,10,11,14,15,3,2,5,4,9,8,13,12
export MXSHMEM_P2P_MAX_DISTANCE=pxb
注:目前Internode 在 C588/C600/N300 平台尚不支持多机运行。
C600U和N300 还需要增加 sm的个数设置,运行参数中需要增加-s 18
单机internode不支持C550机型,除非将550机型当作500机型使用
Intranode
intranode测试不需要网卡,无需设置MXSHMEM_HCA_LIST。
从Release 3.9.0 或 MASTER 20260817-271 SDK-PYTHON 开始:
intranode工作在不同的GPU需要设置MACA_VISIBLE_DEVICES,详细设置如下:
#C600 和N300
export MACA_VISIBLE_DEVICES=0,4,8,12,1,5,9,13,6,2,10,14,7,3,11,15

#C588
export MACA_VISIBLE_DEVICES=0,6,10,14,1,7,11,15,2,4,8,12,3,5,9,13
Release 3.9.0 或 MASTER 20260817-271 SDK-PYTHON 之前版本:
intranode工作在不同的GPU设置的环境变量有区别,详细设置如下:
#C600 和N300
export MACA_EXT_MXDEEPEP_MAX_NVL_PEERS=16
export MACA_VISIBLE_DEVICES=0,4,8,12,1,5,9,13,6,2,10,14,7,3,11,15

#C588
export MACA_EXT_MXDEEPEP_MAX_NVL_PEERS=16
export MACA_VISIBLE_DEVICES=0,6,10,14,1,7,11,15,2,4,8,12,3,5,9,13
Mellanox网卡
export MXSHMEM_HCA_LIST=mlx5_0:1,mlx5_1:1(可用的计算网卡网口)
export MXSHMEM_IB_TRAFFIC_CLASS=160
当网卡模式为ROCE的需要进行设置。InfiniBand模式不要设置!
(实际值需和该章节网卡traffic_class值保持一致,/sys/class/infiniband/mlx5_1/tc/1/traffic_class)
MXRDMA网卡
对于MXRDMA网卡【必须使用MACA SDK Release 3.9.0之后的版本】,额外操作
需要设置额外的环境变量
export MXSHMEM_GDA_PROVIDER=mrdma
export MXSHMEM_HCA_LIST="metax_rdma_0:1,metax_rdma_1:1,metax_rdma_2:1,metax_rdma_3:1,metax_rdma_4:1,metax_rdma_5:1,metax_rdma_6:1,metax_rdma_7:1,metax_rdma_8:1,metax_rdma_9:1,metax_rdma_10:1,metax_rdma_11:1,metax_rdma_12:1,metax_rdma_13:1,metax_rdma_14:1,metax_rdma_15:1"
需要配置PCIE SWITCH 【打开上行功能】
bash
sudo mxrdma_upstreamFwd -s测试文档
测试脚本当前压缩包解压缩,所有的测试脚本默认使用C500,请按照实际产品更新对应环境变量
从Release 3.9.0 或 MASTER 20260818-1323 开始 MACA SDK 包中有deepep的测试文件和测试脚本。
相关的文件位于 /opt/maca/tools/communication/mxdeepep 中:
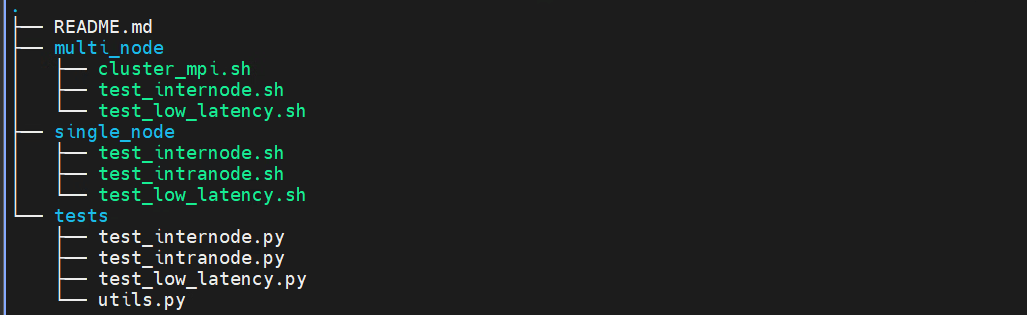
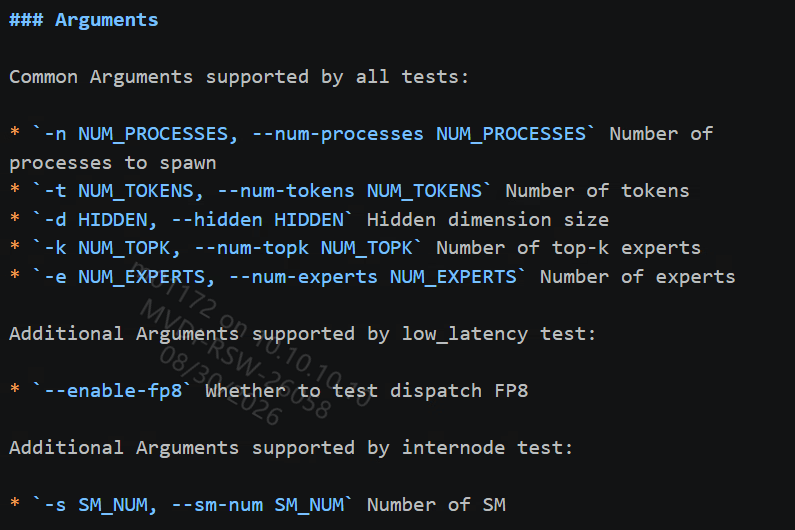
测试的python文件的参数介绍:
注意:
当前测试脚本中 rank数默认为8,测试时需要结合实际的机型和需求进行配置
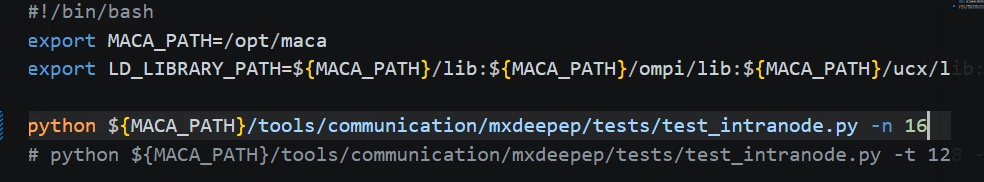
例如C600的机器测试时,需要在对应的测试脚本中增加 参数 -n 16
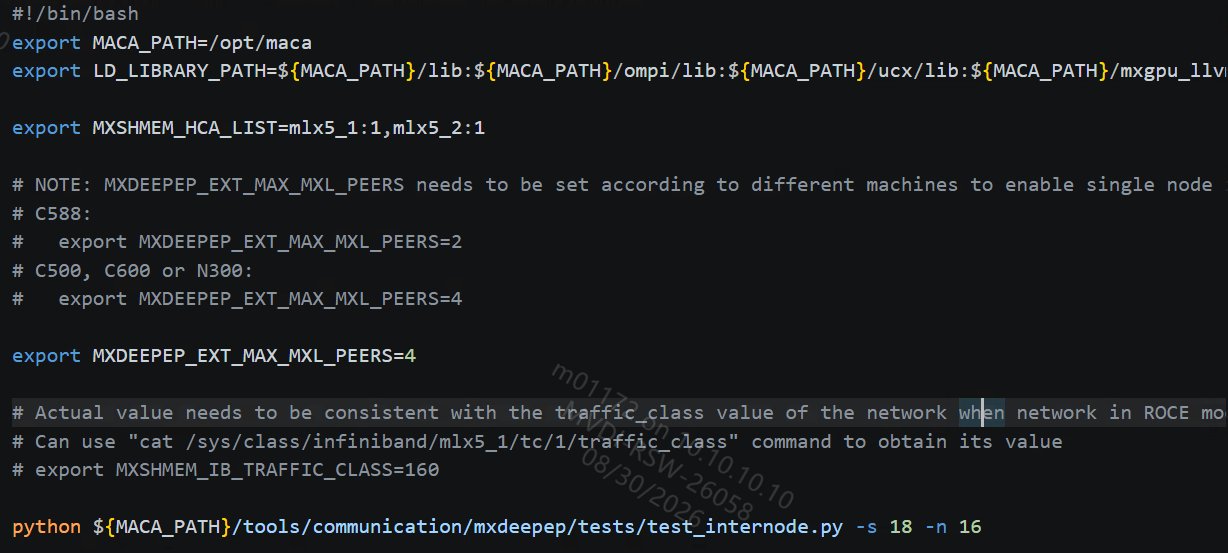
当前internode的测试脚本sm 默认为20,测试时需要根据实际和需求进行配置
N300或C600U的机器上,-s 需要设置为18
执行单机LowLatency测试
配置MXSHMEM_HCA_LIST变量中IB网卡的name,并保证该网卡的状态为active状态
结合产品,参考DEEPEP推荐环境变量设置修改single_node/test_low_latency.sh脚本
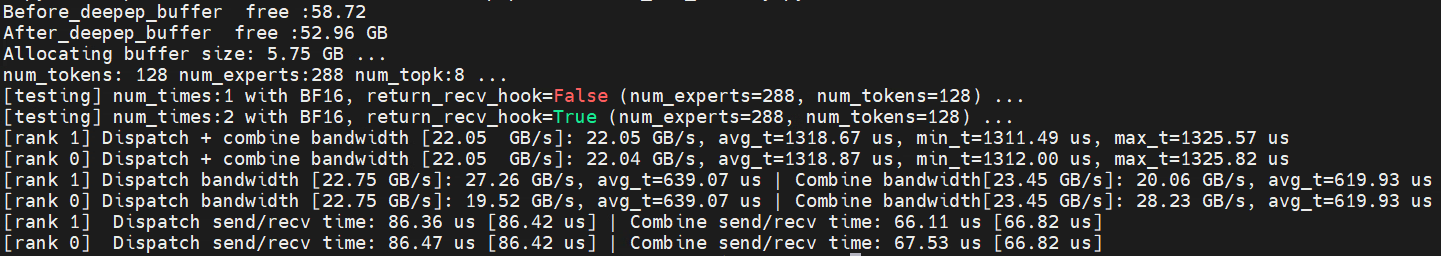
以C500为例,单机LowLatency测试结果:
执行单机Intranode测试
intranode测试不需要网卡,需结合产品,参考DEEPEP推荐设置修改single_node/test_intranode.sh脚本
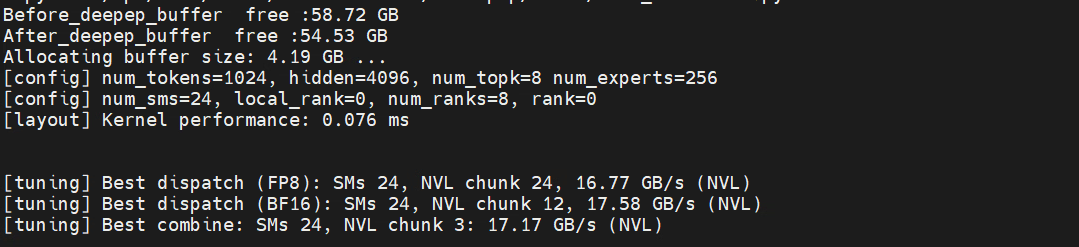
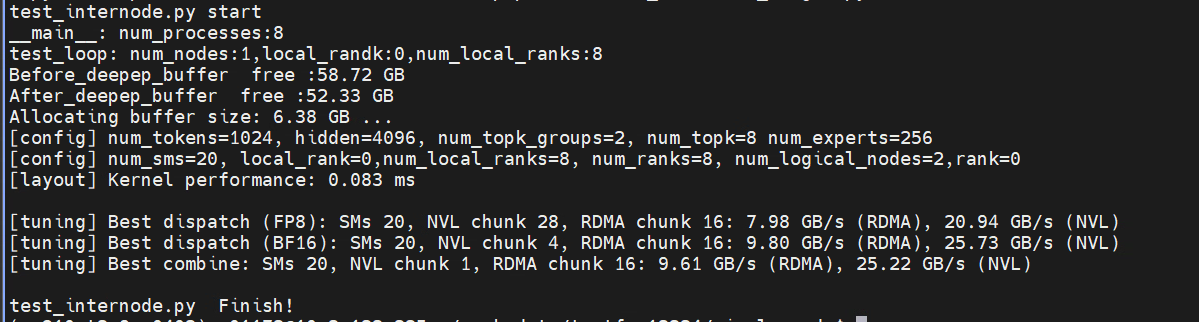
以C500为例,单机intranode测试结果:
执行单机Internode测试
internode测试需要使用网卡
需要配置MXSHMEM_HCA_LIST变量中网卡的name,并保证该网卡的状态为active
结合产品,参考DEEPEP推荐设置修改single_node/test_internode.sh脚本
以C500为例,单机internode测试结果:
DeepEP多机测试
执行多机测试时,需保证每个机器的基础环境软件版本一致,都能够跑通单机测试case。
注意只有Low_latency 和internode算法支持多机测试。
参考上述MCCL测试章节及DeepEP单机测试。
环境变量
从Release 3.9.0 或 MASTER 20260817-271 SDK-PYTHON 开始:
集群多机DEEPEP测试部署需要配置以下变量:
export MXDEEPEP_TEST_MASTER_ADDR=10.2.122.226 (多机通信中该变量保持唯一,作为master rank)
export MXDEEPEP_TEST_MASTER_PORT=29543 (选配)
export MXDEEPEP_TEST_MXDEEPEP_WORLD_SIZE=2 (机器的个数)
export MXDEEPEP_TEST_RANK=0 (master rank主机的环境设置为0,其他主机设置为其他rankID)
export MXSHMEM_BOOTSTRAP_UID_SOCK_IFNAME=enp196s0f1 (管理网卡的name)
export MXSHMEM_HCA_LIST=mlx5_0:1,mlx5_1:1(可用的计算网卡网口)
export MXSHMEM_IB_TRAFFIC_CLASS=160 (与网络配置traffic_class配置保持一致)
当网卡模式为ROCE的需要进行设置。InfiniBand模式不要设置!
(实际值需和RoCE网卡无损参数配置网卡traffic_class值保持一致:
/sys/class/infiniband/mlx5_1/tc/1/traffic_class)
export MCCL_SOCKET_IFNAME=enp196s0f1 (管理网卡的name)
export MCCL_IB_HCA=mlx5_0:1,mlx5_1:1(可用的计算网卡网口)
Release 3.9.0 或 MASTER 20260817-271 SDK-PYTHON 之前版本:
集群多机DEEPEP测试部署,基于单机环境变量的设置外,还需要配置以下变量:
export MASTER_ADDR=10.2.122.226 (多机通信中该变量保持唯一,作为master rank)
export MASTER_PORT=29543 (选配)
export WORLD_SIZE=2 (机器的个数)
export RANK=0 (master rank主机的环境设置为0,其他主机设置为其他rankID)
export MXSHMEM_BOOTSTRAP_UID_SOCK_IFNAME=enp196s0f1 (管理网卡的name)
export MXSHMEM_IB_TRAFFIC_CLASS=160 (与网络配置traffic_class配置保持一致)
当网卡模式为ROCE的需要进行设置。InfiniBand模式不要设置!
(实际值需和RoCE网卡无损参数配置网卡traffic_class值保持一致:
/sys/class/infiniband/mlx5_1/tc/1/traffic_class)
export MCCL_SOCKET_IFNAME=enp196s0f1 (管理网卡的name)
export MCCL_IB_HCA=mlx5_0:1,mlx5_1:1(可用的计算网卡网口)
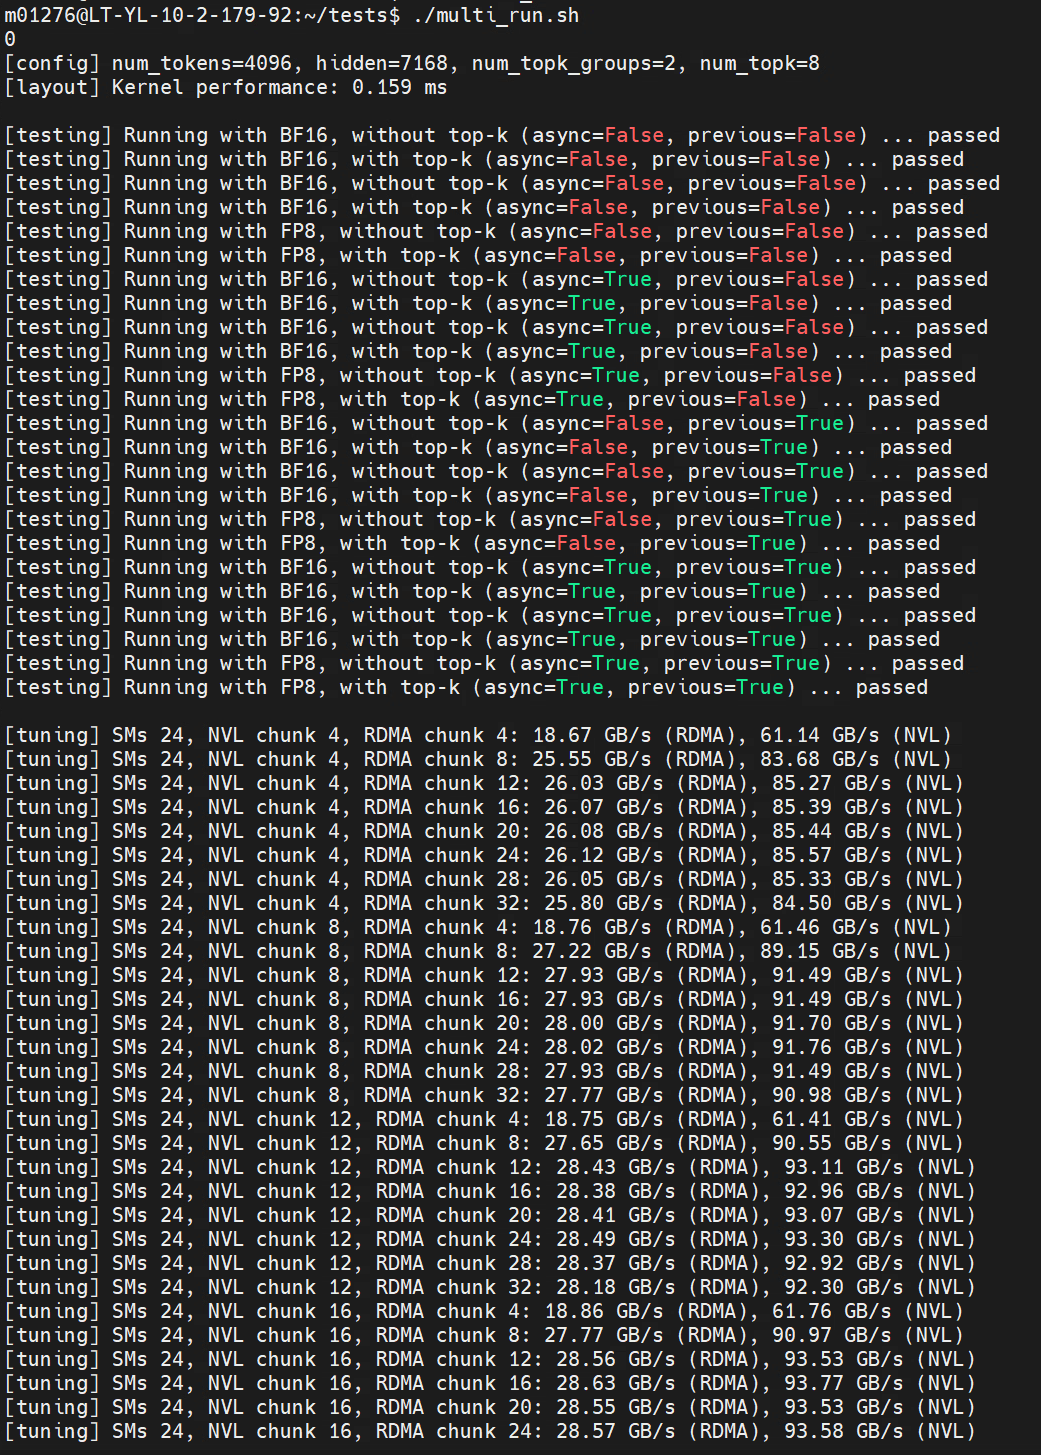
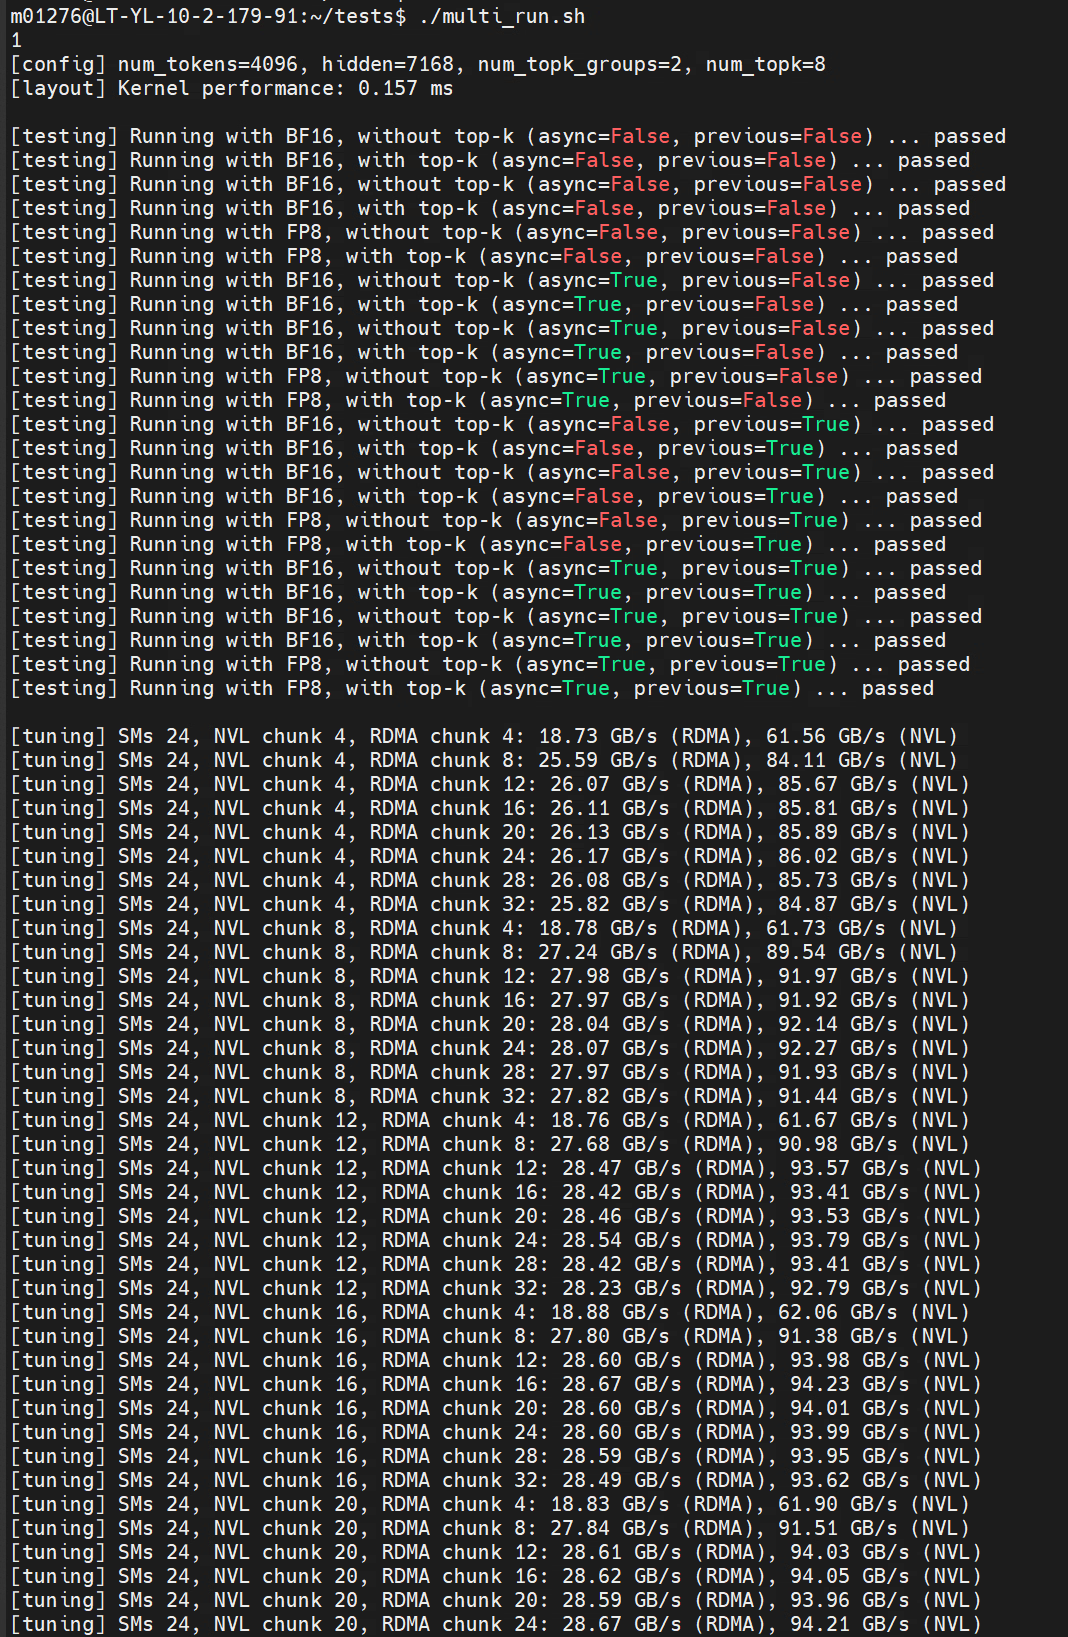
执行多机internode测试
配置MXSHMEM_HCA_LIST变量中IB网卡的name,并保证该网卡的状态为active状态
结合产品,参考DEEPEP推荐环境变量设置修改multi_node/test_internode.sh脚本
以C500为例,多机internode测试结果:
rank0机器
rank1机器
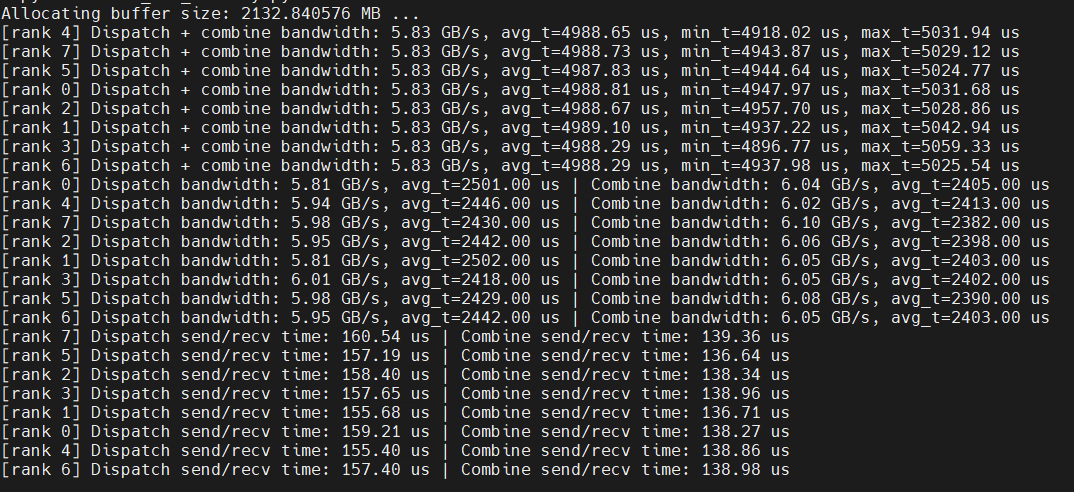
执行low latency多机测试
配置MXSHMEM_HCA_LIST变量中IB网卡的name,并保证该网卡的状态为active状态
结合产品,参考DEEPEP推荐环境变量设置修改multi_node/test_low_latency.sh脚本
以C500为例,多机LowLatency测试结果:
rank0
rank1
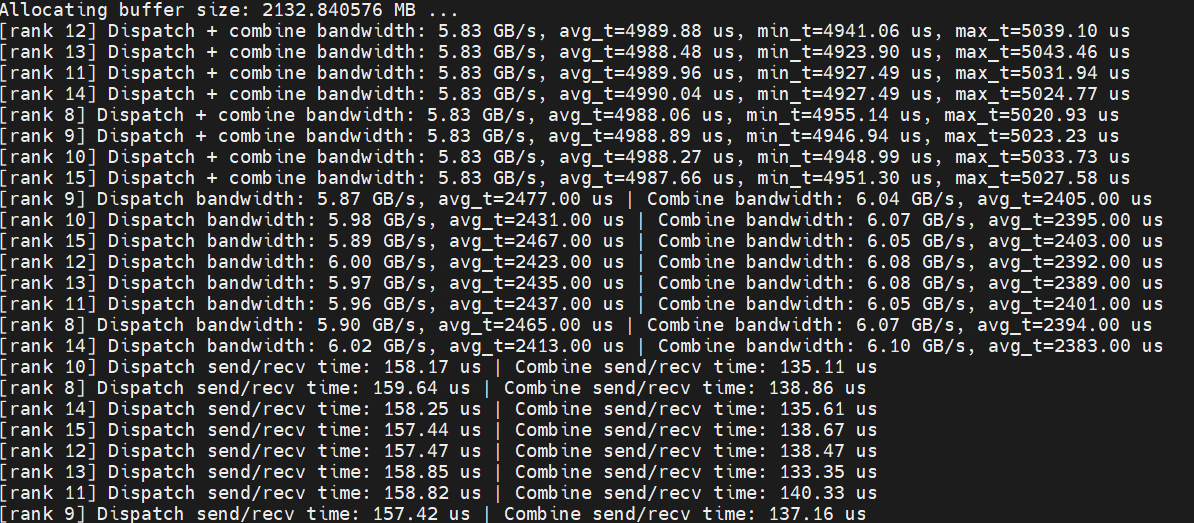
使用mpi执行low latency多机测试
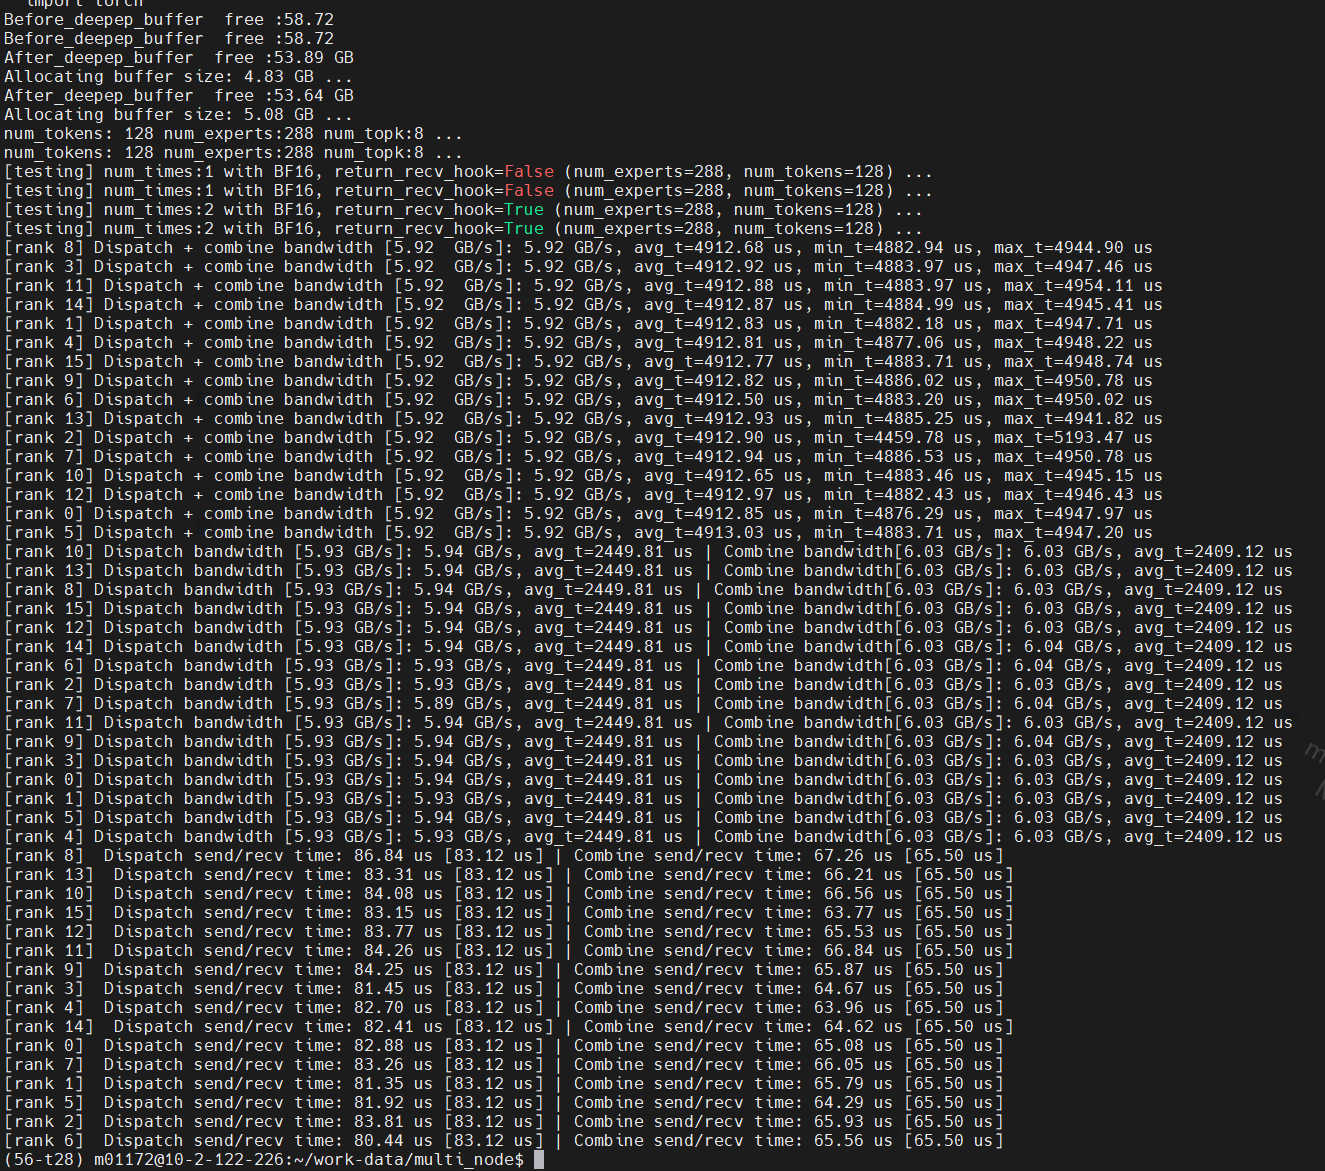
配置MXSHMEM_HCA_LIST变量中IB网卡的name,并保证该网卡的状态为active状态
结合产品,参考DEEPEP推荐环境变量设置修改multi_node/cluster_mpi.sh脚本
使用MPI进行测试时,两机之间需要设置免密,参考MCCL多机测试
另外需要注意,若使用mpi进行多机测试时,需要保证deepep安装的位置相同
以C500为例,多机LowLatency测试结果:
MXMesh 单元测试
MXMesh 包含两种算法:low latency、normal算法,当前仅支持low latency算法,normal算法(internode、intranode)暂未支持。MxMesh默认只支持超节点(如shanghai Cube,C588超节点)、单机(如C600U)拓扑,具体可咨询通信库团队。
测试MXMesh前,请保证上述MCCL测试通过,以保证机器或集群为可用状态。
基础环境搭建
基本环境配置及安装包获取,与deep_ep 配置和安装一样,参考deep_ep相关内容。需要注意的是:
deep_ep 与 mxmesh 当前是独立互斥的, 两者不能混合使用。安装mxmesh之前要先卸载deep_ep,安装deep_ep 之前要先卸载mxmesh.
与deep_ep区别及使用方法
python import模块名称还是一样的:import deep_ep
区别在low_latency_dispatch接口上,mxmesh比deep_ep多一个topk_weights 参数
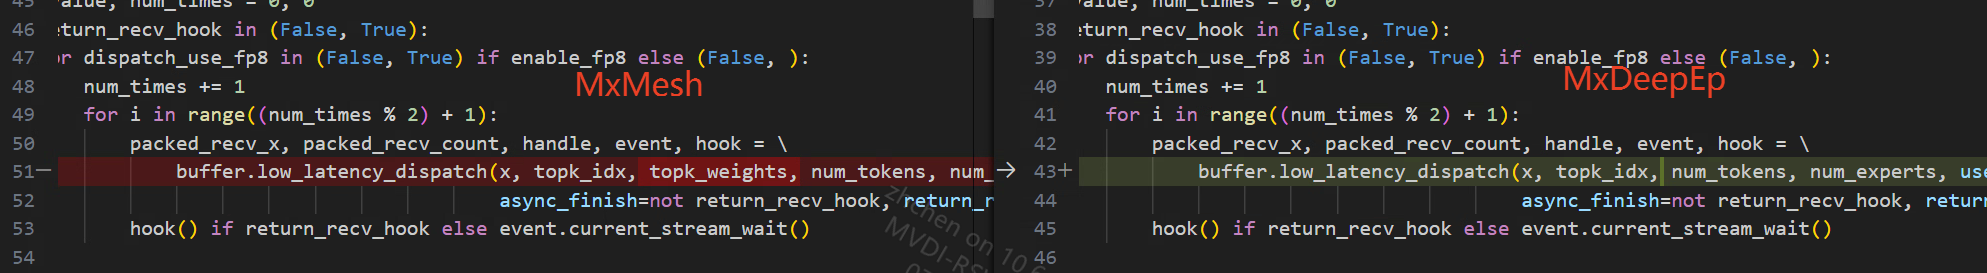
mxmesh 单元测试
请至钉钉文档查看附件《test_ll_mxmesh.py》。
与deep_ep测试脚本一样,下载附件py两个文件,可参考如下测试脚本修改测试:
#!/bin/bash

pip uninstall deep_ep -y

export MACA_PATH=/opt/maca/

# NOTE: check your folder name
export LD_LIBRARY_PATH=${MACA_PATH}/mxgdrcopy/lib/:${MACA_PATH}/lib:${MACA_PATH}/ompi/lib:${MACA_PATH}/mxgpu_llvm/lib

# Run test cases
# NOTES: you may modify the `init_dist` function in `tests/utils.py`
# according to your own cluster settings, and launch into multiple nodes
# master主机地址保持唯一
export MASTER_ADDR=10.0.82.169
export MASTER_PORT=29568
export WORLD_SIZE=1
# master设置为0,其他主机设置为其他rankID eg:1,2,3
export RANK=0

ifname=$(ip route show default | awk '/default/ {print $5; exit}')
export MCCL_SOCKET_IFNAME=${ifname}
echo "Node $RANK, socket: ${MCCL_SOCKET_IFNAME}"

export MACA_DIRECT_DISPATCH=1
export MXMESH_TIMEOUT_PRINT=1
#export MACA_KERNEL_TIMEOUT=60000

python3 test_ll_mxmesh.py -e 256 -t 128 -n 32  #--enable-fp8
mxmesh 支持情况
mxmesh LL当前使用限制见附录MXMesh支持情况章节。
MPI 测试
MPI测试通常使用OSU Micro-Benchmarks进行测试,OSU bench来源于开源社区,通过对其适配并集成发布到了maca包中(release 3.8.3之后版本)。
文件目录/opt/maca/tools/communication/mpi/osu_benchmark,单机测试使用single.sh,多机测试使用cluster.sh。
注:osu gather测试目前仍有遗留问题,可不测试。