Appearance
异构混训集群
异构混训是指使用不同厂商GPU构建的集群进行模型训练的场景,如沐曦、英伟达、天数等GPU。同构集群是指同一型号的GPU构建的集群。
如果使用异构混训,需按照本章节所述完成所有部署项。本章节只讲述和同构的差异点,其余为和同构相同点。因此,部署异构集群前首先按照同构方式部署Metax 机器。
异构功能目前以插件的方式集成到我们的mccl中,使用时请确保/opt/maca/lib目录下包含libmccl.so以及对应的插件库(一般命名末尾带plugin的.so,如libmxccl_21403plugin.so、libmxccl_21605plugin.so)。插件名中的5位数字表示版本号,与nccl版本相对应:
| 插件版本(版本号对应nccl) | 对应插件库文件命名 | 备注 |
|---|---|---|
| mxccl2.14.3 | libmxccl_21403plugin.so | 对应nccl2.14.3 |
| mxccl2.13.8 | libmxccl_21605plugin.so | 对应nccl2.13.8 |
| mxccl2.16.5 | libmxccl_21605plugin.so | 对应nccl2.16.5 |
| mxccl2.20.5 | libmxccl_22005plugin.so | 对应nccl2.20.5 |
以下内容均以沐曦和英伟达的GPU为例,天数、华为等其他国产GPU的异构混训大部分流程相同,不同的部分在本文 "其它国产GPU异构"。
异构集群环境配置
通用配置
- 网卡驱动安装
集群中所有机器,参见本文《网卡驱动安装》章节。
- MPI 安装
集群中所有机器安装相同版本的 MPI,可以使用以下两种方法: 方法一:在Metax机器上安装 MACA 包,然后将 /opt/maca/ompi 目录 copy 到 A100 机器的同名目录下(推荐) 方法二:下载某一版本 MPI,在 C500 和 A100 机器上分别下载安装(使用此方法,无法直接使用 maca 包中的 mccl-perf ,需重新编译)
- RoCE/IB 网络配置
(1)确认所有机器位于同一个子网中(同一交换机 /spine-leaf 交换机系统),确认交换机类型(RoCE 与 IB 交换机不能通用),根据交换机类型设置网卡工作模式(以 Mellanox 网卡为例,可软件配置工作在 RoCE/IB 模式下);
(2)如果是 RoCE 集群,配置 RoCE 地址在同网段下;
集群内所有机器的免密通信配置
设置环境变量,确保 LD_LIBRARY_PATH 指向相同的 MPI 路径,可通过命令ldd <mccl/nccl perf test name>查看。
Nvidia 机器配置
安装 GPU 驱动 / CUDA 驱动
安装 nvidia-peer-memory(GDR 必须)
安装 nccl(版本根据要适配MXCCL的版本选择)
环境变量配置
训练脚本环境变量
通用环境变量,Metax & 其他厂家都需要设置;如果是国产GPU异构,还需要添加后文 "国产GPU异构"中对应的环境变量
# MxCCL Enable
# export NCCL_FORCE_USE_MN_MIX=1 # 置0或移除(根据硬件环境自适应选择同构/异构)
export MCCL_EXT_CCL_ENABLE=1
export MCCL_HC_PLUGIN=${MACA_PATH}/lib/libmxccl_21403plugin.so

# Net ENV  根据实际网络环境配置
export NCCL_SOCKET_IFNAME=bond0   #用做socket通信的网卡,ifconfig确认好网卡名字,不同机器的网卡名不同可以用逗号隔开,例如:enP3s48f0,enP3s48f1
export MCCL_SOCKET_IFNAME=bond0
export NCCL_IB_GID_INDEX=3  #详细说明见本文7.4.3章节,后续mxccl 已自适应,无需再配置
export NCCL_IB_TC=138  #指定使用的InfiniBand流量类别,从而优化通信库在IB网络上的通信性能
export NCCL_IB_HCA=mlx5_0,mlx5_1,mlx5_2,mlx5_3   # IB HCA ENV

# Common ENV
export NCCL_BUFFSIZE=8388608
export NCCL_ALGO=Ring
export NCCL_PROTO=Simple
export NCCL_P2P_LEVEL=PXB
export NCCL_NET_GDR_LEVEL=7
export NCCL_CROSS_NIC=1
export PATH=/opt/conda/bin/:${PATH}

# Debug info
export MCCL_DEBUG=error  // mccl日志等级  info   trace  error
export NCCL_DEBUG=error  // 插件日志等级
export MCCL_DEBUG_SUBSYS=INIT
export NCCL_DEBUG_SUBSYS=INIT   //debug信息   ^ALLOC
注:其中必须配置的环境变量包括
export MCCL_EXT_CCL_ENABLE=1  // 使用异构插件的开关
export MCCL_HC_PLUGIN=/xxx/libmxccl_21403plugin.so // 指定插件路径,根据实际情况指定对应版本so
# export NCCL_FORCE_USE_MN_MIX=1  // 在同构机器上调试异构插件的开关

// 2.14和2.16版本目前还必须设置以下环境变量
export NCCL_BUFFSIZE=8388608
export NCCL_ALGO=Ring               // 指定使用的算法
export NCCL_PROTO=Simple            // 指定使用的协议
其他环境变量(主要用于调试、打印日志,排查定位问题)
export MCCL_DEBUG=error  // mccl日志等级  info   trace  error
export NCCL_DEBUG=error  // 插件日志等级
export MCCL_DEBUG_SUBSYS=INIT
export NCCL_DEBUG_SUBSYS=INIT   //debug信息   ^ALLOC
异构通信库测试
首先分别做单机测试保证Nvidia机器和Metax机器单机状态是正常的,然后再进行异构多机测试。
Nvidia机器单机测试
确认nvidia机器上安装的NCCL版本与Metax 机器安装的异构插件mxccl版本对齐(mxccl2.16.5对应nccl2.16.5)。
nccl的perf文件获取:
方式一:从MACA发布包的/opt/maca/samples/mccl_tests/perf/nccl_perf/路径下拷贝到NVIDIA机器对应目录,并将NVIDIA机器对应的文件夹重命名为mxccl_perf (推荐)
方式二:从GitHub上下载对应版本(nccl-test-2.13.8)直接编译产生perf复制到相应目录,方法如下:
下载 nccl-tests(版本为 tag-2.13.8)并编译生成可执行文件在解压后的文件夹中执行命令:make MPI=1 MPI_HOME=/path/to/mpi CUDA_HOME=/path/to/cuda NCCL_HOME=/path/to/nccl。 使用 maca 的 mpi 的情况下,MPI_HOME=/opt/maca/ompi;自己编译安装 mpi 的情况下MPI_HOME 为 mpi 的安装目录。CUDA_HOME 和 NCCL_HOME 根据实际情况赋值。
NCCL单机测试脚本:
/opt/maca/samples/mccl_tests/perf/nccl_perf/nccl.sh
#!/bin/bash

export MACA_PATH=/opt/maca
export LD_LIBRARY_PATH=${MACA_PATH}/lib:${MACA_PATH}/ompi/lib #指定MPI对应的lib目录

export FORCE_ACTIVE_WAIT=1
export NCCL_P2P_LEVEL=SYS
export NCCL_DEBUG=INFO   #打印日志
export NCCL_LIMIT_RING_LL_THREADTHRESHOLDS=1

#nccl perf 路径
BENCH_NAME=${MACA_PATH}/samples/mccl_tests/perf/mxccl_perf/all_reduce_perf
GPU_NUM=4   #GPU数量

if [[ $1 -gt 0 && $1 -lt 65 ]]; then
GPU_NUM=$1
fi

${MACA_PATH}/ompi/bin/mpirun -n ${GPU_NUM} --allow-run-as-root -mca pml ^ucx ${BENCH_NAME} -b 1K -e 1024M -f 2 -g 1 -n 10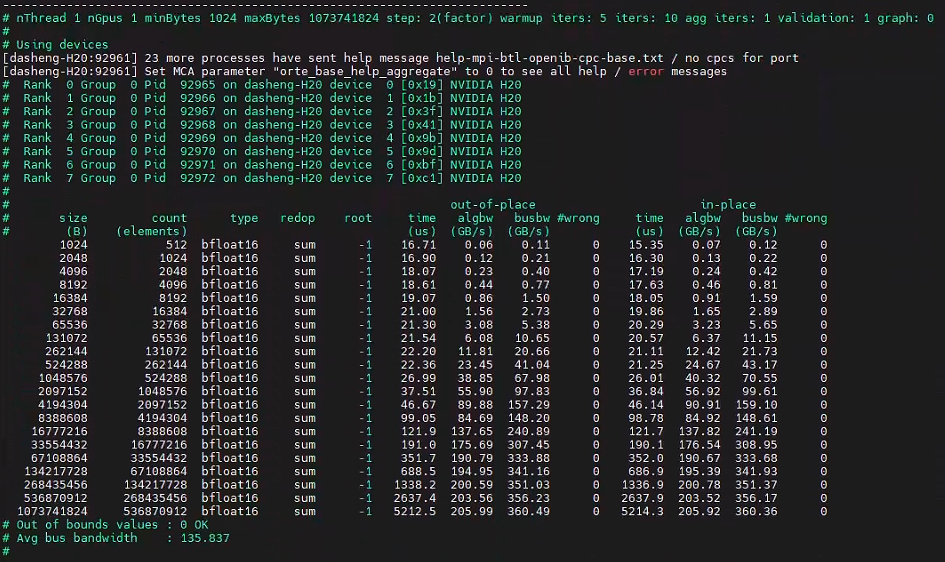
Metax单机测试
测试单机MXCCL可以使用mccl的perf或mxccl的perf
mxccl的perf文件在maca包里的路径为:/opt/maca/samples/mccl_tests/perf/mxccl_perf/
单机执行脚本:/opt/maca/samples/mccl_tests/perf/mxccl.sh
#!/bin/bash

export MACA_PATH=/opt/maca
export LD_LIBRARY_PATH=${MACA_PATH}/lib:${MACA_PATH}/ompi/lib
export FORCE_ACTIVE_WAIT=1

GPU_NUM=4
VERSION=21605   #插件版本
LOG_LEVE=error  #日志等级,置为info可打印调试信息

#插件相关配置
export NCCL_FORCE_USE_MN_MIX=1  #强制在沐曦机器走MXCCL插件,只是在沐曦同构测试中使用
export MCCL_EXT_CCL_ENABLE=1    #允许加载插件
export MCCL_HC_PLUGIN=${MACA_PATH}/lib/libmxccl_${VERSION}plugin.so  #指定插件路径

BENCH_NAME=${MACA_PATH}/samples/mccl_tests/perf/mxccl_perf/all_reduce_perf

DEBUG_INFO="-x NCCL_DEBUG=${LOG_LEVE} -x MCCL_DEBUG=${LOG_LEVE}"
COMM_SET="-x NCCL_BUFFSIZE=8388608 -x NCCL_ALGO=Ring -x NCCL_PROTO=Simple -x  NCCL_LIMIT_RING_LL_THREADTHRESHOLDS=2 -x NCCL_P2P_LEVEL=SYS"

if [[ $1 -gt 0 && $1 -lt 65 ]]; then
GPU_NUM=$1
fi

${MACA_PATH}/ompi/bin/mpirun -n ${GPU_NUM} --allow-run-as-root -mca pml ^ucx ${DEBUG_INFO} ${COMM_SET} ${BENCH_NAME} -b 1K -e 1024M -f 2 -g 1 -n 10
注:如果使用MXCCL的perf,测试脚本末尾不能加 【-d bfloat16】这个参数
异构多机测试
异构环境测试多机的perf时Metax机器必须使用MXCCL的perf.
将NVIDIA机器的perf文件放到和Metax机器的perf文件相同的文件夹下(mpirun 使用的要求)
perf文件路径为:/opt/maca/samples/mccl_tests/perf/mxccl_perf/
双机或多机异构执行脚本:/opt/maca/samples/mccl_tests/perf/xccl.sh(多机需修改脚本中的HOST_IP和GPU_NUM)
export MACA_PATH=/usr/local/cuda
export TEST_LIB=/opt/maca/lib

TEST_DIR=/opt/maca/samples/mccl_tests/mxccl_perf/   #perf路径  nv机器和mx机器perf需放在相同目录下
#BENCH_NAMES="all_reduce_perf all_gather_perf reduce_scatter_perf sendrecv_perf scatter_perf reduce_scatter_perf alltoall_perf broadcast_perf"
BENCH_NAMES="all_reduce_perf"

HOST_IP=10.21.61.25:8,10.21.61.26:8 #IP:GPU数量
IP_MASK=10.21.61.0/24
GPU_NUM=16
VERSION=21605 #异构插件版本
IB_PORT=mlx5_0,mlx5_1
LOG_LEVEL=error #日志等级

if [[ -z "$1" || -z "$2" || -z "$3" || -z "$4" ]]; then
echo "Use the default ip addr. Run with parameters for custom ip addr, for example: bash cluster.sh ip_1 ip_2 ip_mask gpu_num"
else
HOST_IP=$1,$2
IP_MASK=$3
GPU_NUM=$4
fi

MPI_RUN_OPT="--allow-run-as-root -mca btl_tcp_if_include ${IP_MASK} -mca pml ^ucx -mca osc ^ucx -mca btl ^openib"
MXCCL_ENABLE="-x MCCL_EXT_CCL_ENABLE=1 -x  MCCL_HC_PLUGIN=/opt/maca/lib/libmxccl_${VERSION}plugin.so"
DEBUG_ENV="-x NCCL_DEBUG=${LOG_LEVEL} -x NCCL_DEBUG_SUBSYS=INIT -x MCCL_DEBUG=${LOG_LEVEL} -x MCCL_DEBUG_SUBSYS=INIT"
NET_ENV="-x NCCL_IB_DISABLE=0 -x NCCL_SOCKET_IFNAME=ens,bond"  #NCCL_IB_DISABLE=1 则禁用IB,通过socket传输
IB_HCA_ENV="-x NCCL_IB_HCA=${IB_PORT}"
COMMON_ENV="-x NCCL_BUFFSIZE=8388608 -x NCCL_ALGO=Ring -x NCCL_PROTO=Simple -x NCCL_LIMIT_RING_LL_THREADTHRESHOLDS=1 -x NCCL_P2P_LEVEL=SYS -x NCCL_NET_GDR_LEVEL=7 -x NCCL_CROSS_NIC=1"
UMD_ENV=" -x FORCE_ACTIVE_WAIT=1"

for BENCH in ${BENCH_NAMES}; do
echo "${TEST_DIR}/${BENCH}"
/opt/maca/ompi/bin/mpirun -n ${GPU_NUM} -host ${HOST_IP} ${MPI_RUN_OPT} ${MXCCL_ENABLE} ${UMD_ENV} ${COMMON_ENV} ${IB_HCA_ENV} ${DEBUG_ENV} ${NET_ENV} -x LD_LIBRARY_PATH=${TEST_LIB}:${MPI_HOME}/lib ${TEST_DIR}/${BENCH} -b 1K -e 1G -g 1 -f 2
done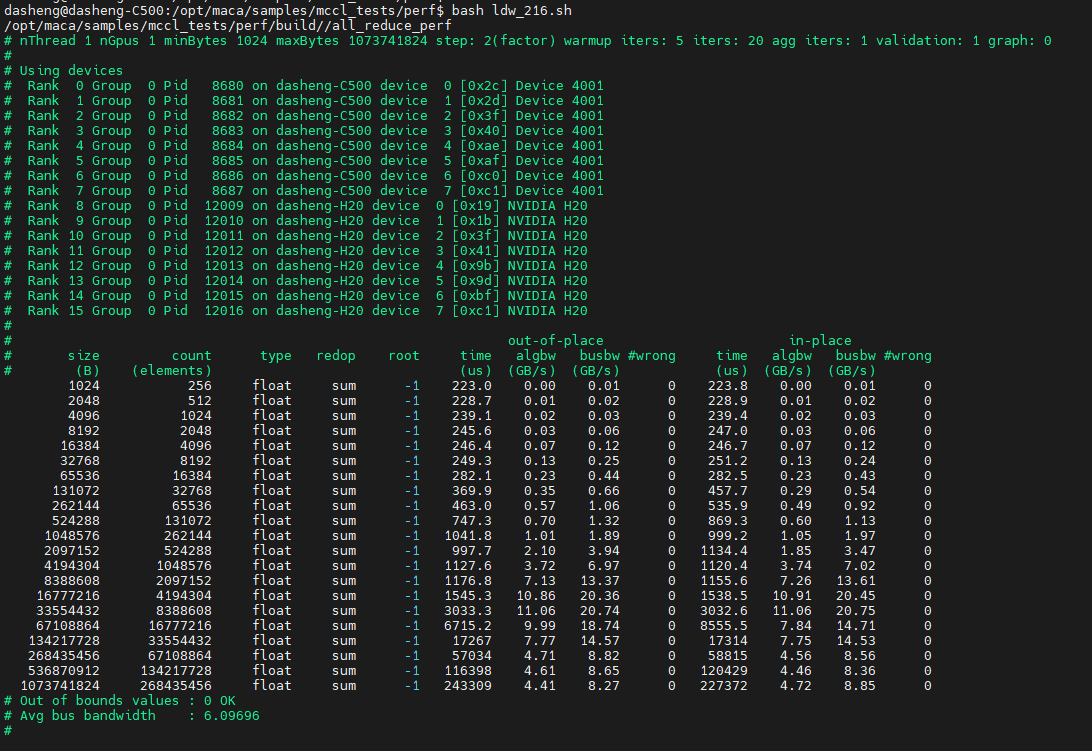
异构生态
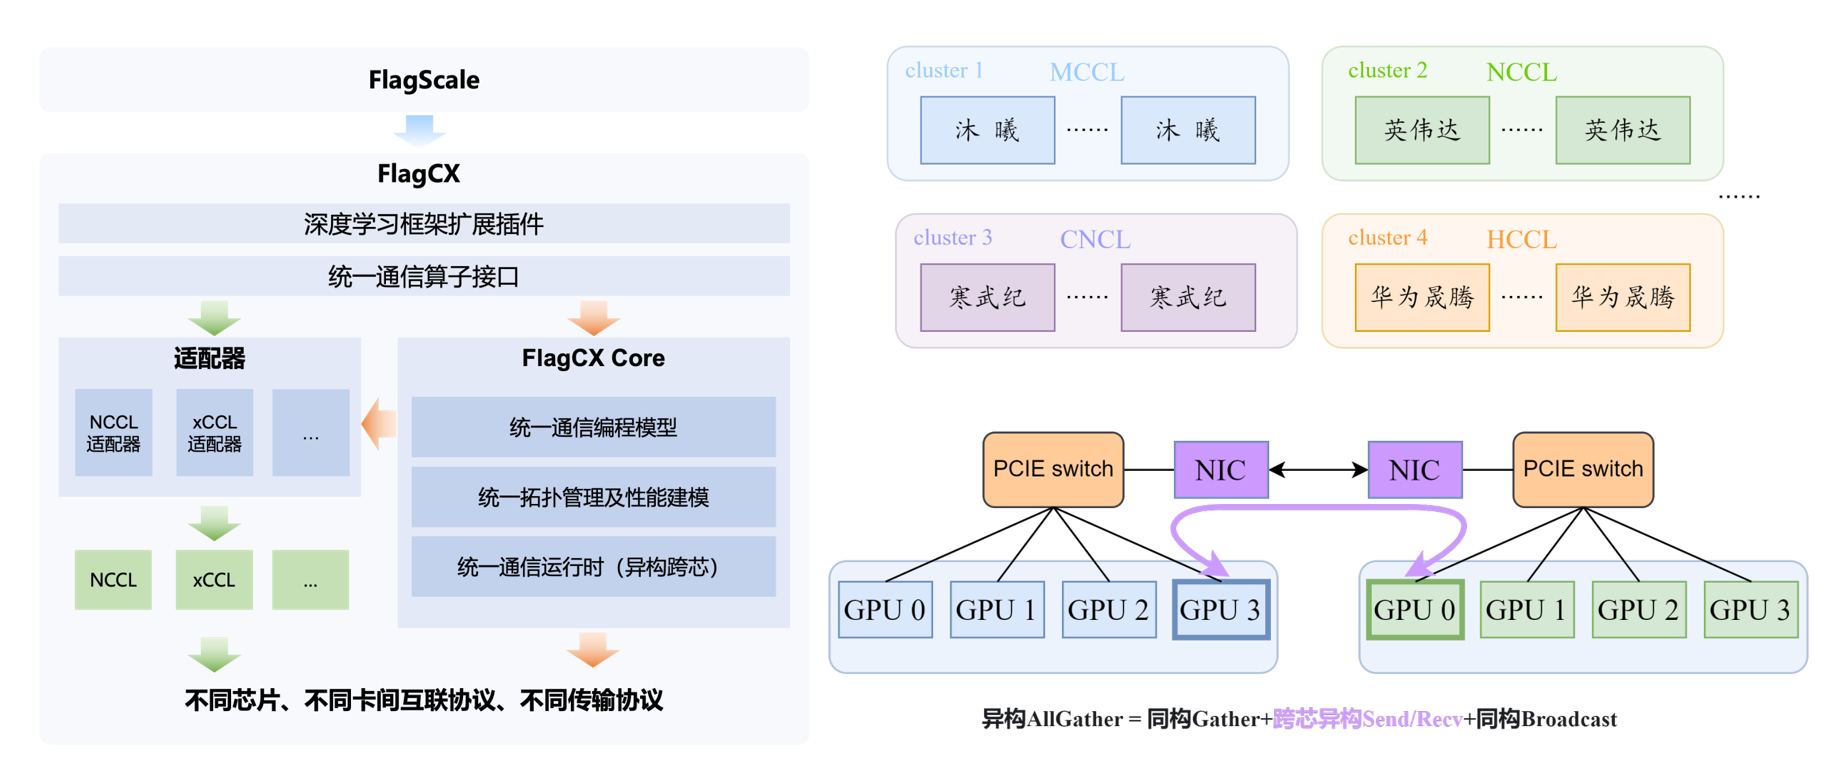
智源Flgcx异构
FlagCX是智源研究院开源的一个异构通信库,为了实现不同芯片之间高效通信FlagCX提供了统一的通信算子接口层。该接口层在同构环境下支持调用各芯片厂商原生的通信库,异构环境下先根据机器类型划分多个cluster,每个cluster内调用原生通信库,cluster之间使用接口层提供的sendrecv通信。
基于FlagCX通信库可以实现Metax GPU和寒武纪、华为、摩尔等国产芯片的异构通信。
天数GPU异构
目前和天数异构主要适配的是mxccl2.14版本,由于天数对通信原语有如下限制:
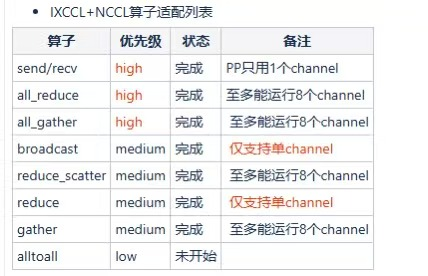
因此在基础配置的环境变量基础上再分别增加如下的环境变量:
export NCCL_P2P_NCHANNELS=1
export NCCL_P2P_NCHANNELS_PEER=1
export NCCL_BUFFSIZE=8388608  #已在基础配置中有配置
export NCCL_ALGO=Ring   #已在基础配置中有配置
export NCCL_PROTO=Simple  #已在基础配置中有配置

export NCCL_MAX_P2P_NCHANNELS=1
export NCCL_MAX_NCHANNELS=1
export NCCL_MIN_NCHANNELS=1
export NCCL_P2P_NET_CHUNKSIZE=1048576
export NCCL_CHUNK_SIZE=1048576
export NCCL_NET_SHARED_BUFFERS=0
export NCCL_P2P_LL_THRESHOLD=0
#export NCCL_NET=Ib
export NCCL_P2P_NET_CHUNKSIZE=1048576
export NCCL_CHUNK_SIZE=1048576
export NCCL_BUFFSIZE=8388608   #已在基础配置中有配置
export NCCL_ALGO=Ring    #已在基础配置中有配置
export NCCL_PROTO=Simple   #已在基础配置中有配置
export NCCL_MAX_NCHANNELS=1
export NCCL_MIN_NCHANNELS=1
export NCCL_MAX_P2P_NCHANNELS=1
export NCCL_NET_SHARED_BUFFERS=0
export NCCL_P2P_LL_THRESHOLD=0

#天数专属用于异构环境变量
export IXCCL_MIX_NV=1
export IXCCL_FUSED_ENABLE=0
天数perf测试文件见以下附件:
请至钉钉文档查看附件《muxi-tianshu-perf.zip》。
常见问题
确认异构插件加载
测试perf时可以打开日志export MCCL_DEBUG=info export NCCL_DEBUG=info,如果只是在起始和结束位置有MCCL INFO相关日志提示插件加载和关闭,中间全部是MXCCL INFO。则表示插件正确加载并生效。如:
dasheng-C500:44853:44853 [0] MCCL INFO MCCL_EXT_CCL_ENABLE set by environment to 1.
dasheng-C500:44853:44853 [0] MCCL INFO MCCL/Plugin: plugin path set to /opt/maca/lib/libmxccl_plugin.so
dasheng-C500:44853:44853 [0] MCCL INFO MCCL/Plugin: Using mccl plugin MXCCL
...
dasheng-C500:44851:44883 [0] MXCCL INFO Connected all rings comm 0x8ec3240 nRanks 04 busId 2c000
...
dasheng-C500:44851:44851 [0] MCCL INFO MCCL/Plugin: Closing plugin: 'MXCCL'
异构多机测试只有使用插件才能成功。
运行perf测试脚本报错
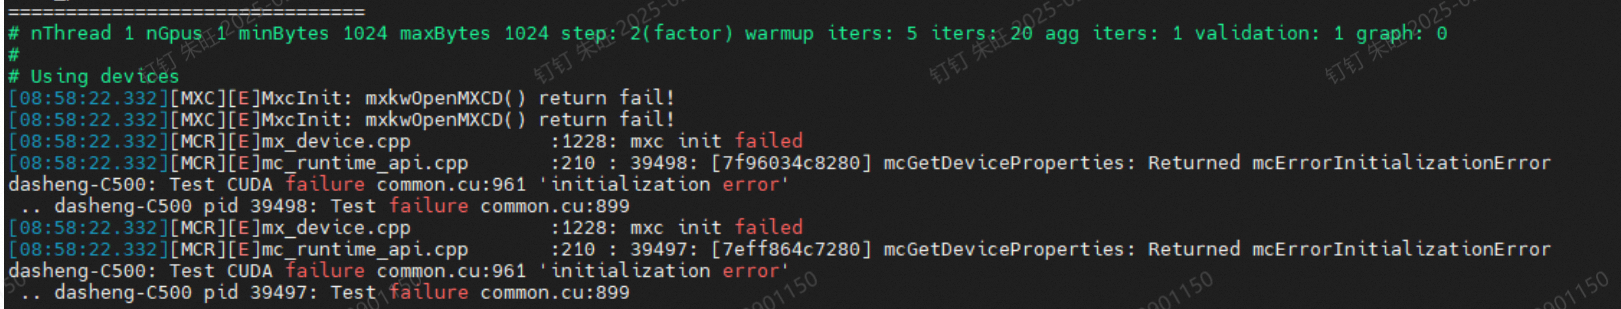
情况一:Metax机器上测试单机perf的脚本有如下报错,尝试用sudo权限执行脚本。如果要取消这个限制,尝试将当前用户添加到video组然后新开一个窗口: sudo usermod -aG video 当前用户
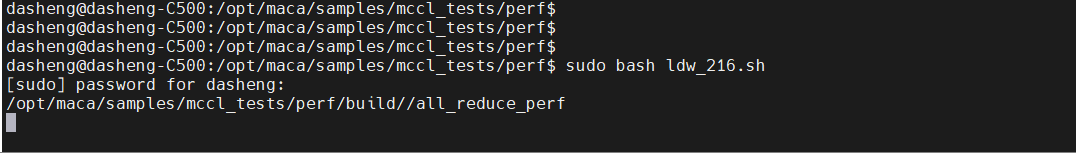
情况二: 多机测试,使用sudo权限执行脚本后没有任何反应,此时排查:1、perf版本是否对齐;2、不使用sudo执行脚本(方法见情况一)
模型训练报错
情况一:正确设置异构的环境变量,测试perf可以成功调用到插件,但是训练模型仍然走MCCL。
问题产生原因:部分pytorch版本底层调用通信库的接口不一致,早期发布的maca包自带的mccl中只有一个初始化接口包含了的异构适配,需升级mccl相关库。
解决方法:升级MACA版本或使用最新maca包中的mccl库和对应的插件库替换原maca包库文件(这里的最新是指maca版本大于release 2.29.0.13)
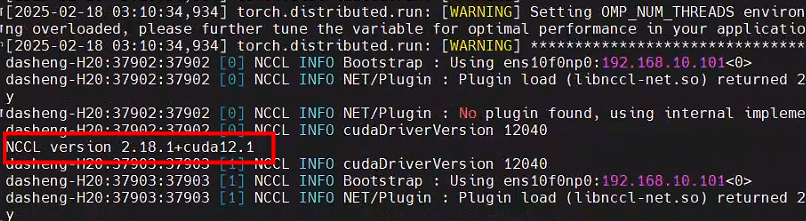
情况二:NVIDIA机器中pytorch版本调用的nccl版本和安装版本不一致
问题产生原因:使用pytorch训练模型环境检查阶段有自动安装nccl的pip指令(可通过pip list | grep nccl指令查看)导致实际运行时调用的nccl版本和预期不符,具体版本可通过日志查看。
此时强制卸载高版本的nccl会有如下提示,跑模型也会有报错:
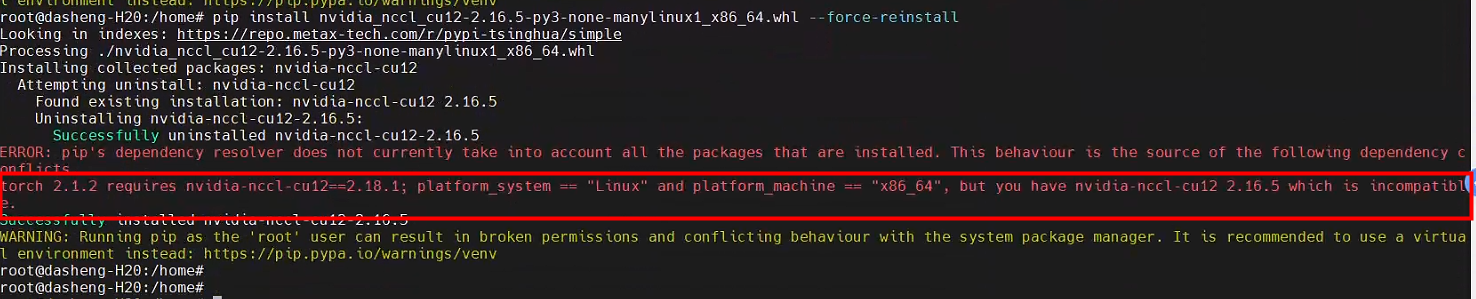
解决方法:使用pytorch的源码,修改源码里面nccl的版本重新编译安装。或者使用更高版本的mxccl.
网络异常
异构集群网络和同构一致,排查问题可参考本文第七章 "IB/RoCE网卡测试"。注意:涉及的相关工具可直接拷贝到N卡使用,但测试使用如下指令:
#server端执行命令:
/opt/maca/samples/mccl_tests/ib_perf/tests/ib_write_bw -a -F --report_gbits -d mlx5_0
#client端执行命令:
/opt/maca/samples/mccl_tests/ib_perf/tests/ib_write_bw  -a -F --report_gbits -d mlx5_0 10.2.122.226
容器部署训练报错
使用docker启动容器,确认挂载网卡和指定共享内存(NVIDIA和沐曦机器都需要),见本文启动docker章节。如未正确指定可能出现如下报错:
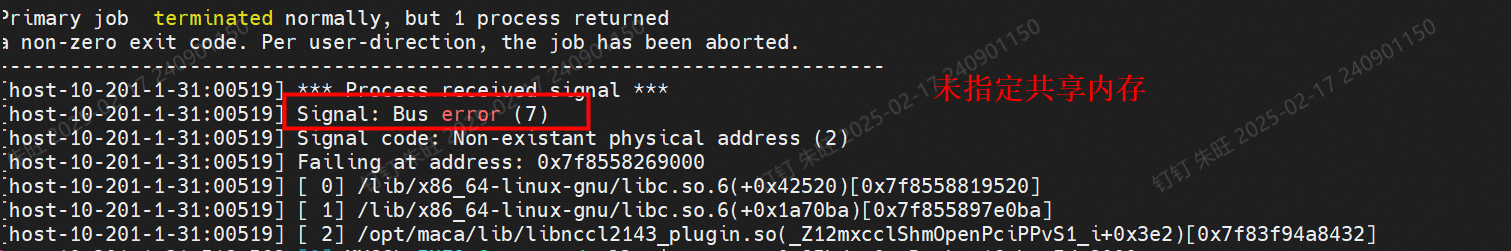
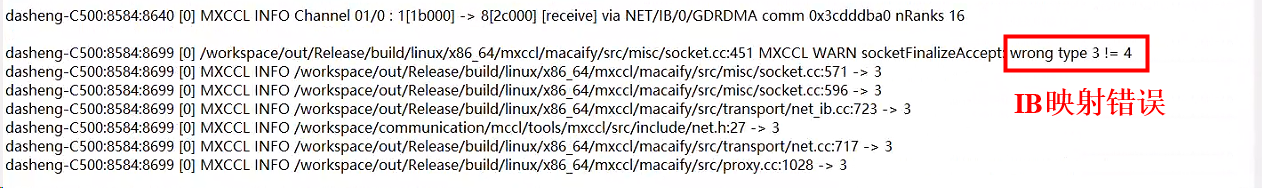
多机测试某些容器docker未正确映射IB,导致一些机器使用IB网络,一些机器使用socket网络:
dmesg报错
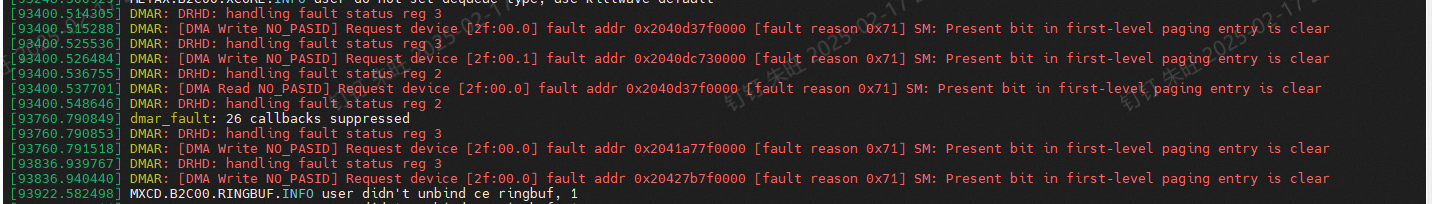
原因:C500机器需要关闭iommu,详见该章节。