Appearance
人工智能计算中心与参数网概述
《H3C RoCE 网络开局一本通》拆分章节,文档版本:6W102。
2.1 产生背景
人工智能作为全球科技领域的高地,近年来得到了飞速的发展。以 ChatGPT 为代表的人工智能技术不仅将对传统行业带来革命性的变革,也向数据中心等基础设施提出了更高的要求。 智算中心是人工智能领域的重要组成部分,肩负着助力人工智能产业的走向兴盛的使命,承担为人工智能企业提供高性能计算资源的重要职责。随着人工智能技术的快速发展,智算中心在智能制造、 大数据分析、深度学习等领域中起着至关重要的作用。
智算中心的规模正在不断扩大,积极响应人工智能和大数据计算需求的爆发式增长。一方面,各大科技公司、高校和科研院所纷纷成立或扩建智算中心,形成了从区域级到国家级的多层次布局。另一方面,政府也在加大对智算中心建设的支持力度,加大计算集群的规模和数量。
布局和规划智算中心,可以为人工智能大模型、 AI 算法等技术的研究提供基础条件,进而提升各个行业的发展,促进数字经济的高质量发展。智算中心的创新发展,有望成为带动人工智能及相关产业快速发展的新引擎。
2.2 总体架构
2.2.1 智算中心典型架构
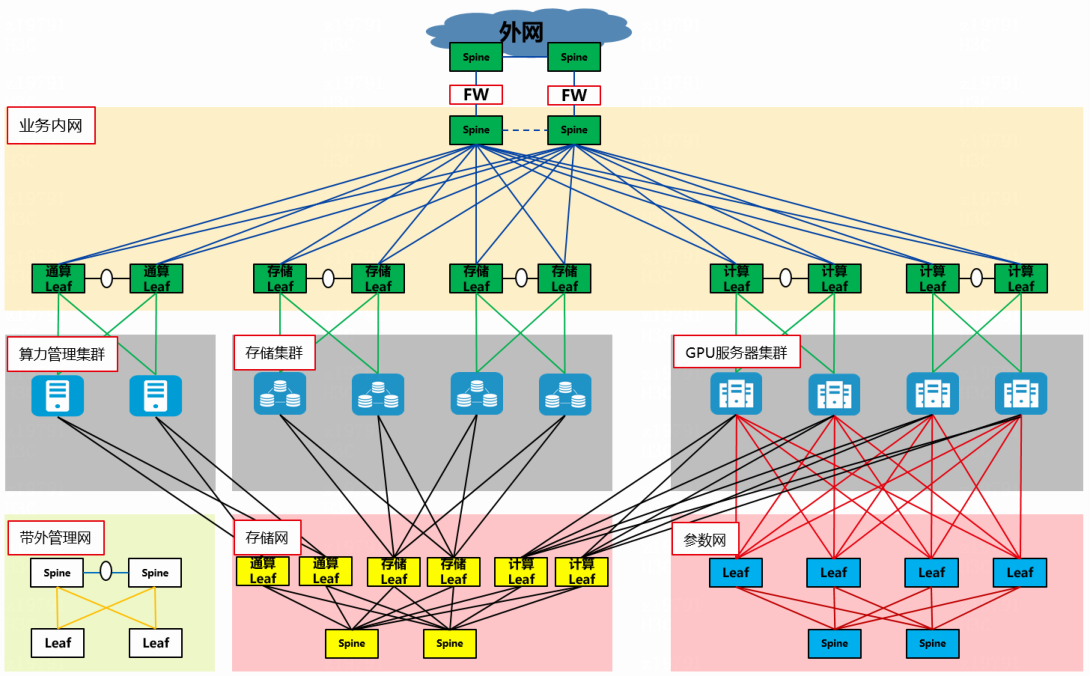
2.2.2 智算中心模块描述
- 参数网
作用: GPU 和 GPU 东西向通信的网络。
无损网络:要求无损网络。
光互联:目前主流为接入 200G, 400G,网络内部互联为 400G, 800G。
设备选型意向:支持 RoCE 的数据中心交换机,通常为高密 200G, 400G, 800G 盒式,框式, DDC 款型。
接入规模:强调大规模接入能力,以能提供的 400G 端口数量为例,大致小型组网数百到 1K 级别,中大型组网 1K-8K 级别,大型组网 8K 以上,超大型组网 100K。
组网形态:因接入规模是 GPU 网卡级别的,根据项目不同,覆盖数百到数百 K 级别,通常为二层盒盒,二层框盒,三层盒盒, DDC 等组网形式。
- 多租户:存在多租户网络隔离需求(Packet Filter acl 隔离方案或 VxLAN 隔离方案)。
- 存储网
作用: GPU 和高性能存储东西向通信的网络。
无损网络:要求无损网络。
光互联:目前主流为接入 100G, 200G;网络内部互联为 200G, 400G。
设备选型意向:支持 RoCE 的数据中心交换机,通常为高密 100G, 200G, 400G 盒式,框式款型。
接入规模:中等规模接入能力,以能提供的 200G 端口数量为例,大致覆盖数十到 K 级别规模。
组网形态:因接入规模是 GPU,存储服务器数量级别,规模中等,通常为二层盒盒组网形式。
多租户:存在多租户网络隔离需求(Packet Filter acl 隔离方案或 VxLAN 隔离方案)。
3. 业务网
作用:连接 GPU 服务器集群,存储集群,算力管理集群,外部网络,打通管理通道。
无损网络:通常不要求无损网络。
光互联:目前主流为接入 25G,网络内部互联为 100G。
设备选型意向:通常为高密 25G 接入, 100G 上行盒式,以及高密 100G 盒式框式数据中心交换机。
接入规模:中等规模接入能力,以能提供的 25G 端口数量为例,大致覆盖数十到 K 级别规模。
组网形态:因接入规模服务器数量级别,规模中等,通常为二层盒盒组网形式。
多租户:存在多租户网络隔离需求(Packet Filter acl 隔离方案或 VxLAN 隔离方案)。
4. 带外管理网
作用:连接 GPU 服务器集群,存储集群,算力管理集群,参数网络,存储网络,业务网络交换机设备的带外管理,打通计算,网络节点和管理软件控制器分析器的管理通道。
无损网络:通常不要求无损网络。
设备选型意向:园区交换机,高密 1G 接入能力。
光互联:目前主流为接入 1G;网络内部互联为 10G。
接入规模:中等规模接入能力,以能提供的 1G 端口数量为例,大致覆盖数十到 K 级别规模。
组网形态:因接入规模是服务器 + 交换机数量级别,规模中等,通常为二层盒盒组网形式。
多租户:通常不存在多租户隔离需求。
5. GPU 集群
GPU 服务器,目前通常提供 8 个 200G/400G 网卡连接参数网,提供 2 个 100G/200G 网卡连接存储网的计算 Leaf,提供 2 个 25G 网卡连接业务网。
6. 高性能存储集群
高性能存储集群,目前通常提供 2 个或者 4 个 100G/200G 网卡,双归属连接存储网络的存储 Leaf, 提供 2 个 25G 网卡连接业务网。
7. 算力管理集群
通算服务器,部署智算管理节点,比如算力调度平台,云平台等;目前通常提供 2 个 25G 网卡连接业务网。
2.3 参数网介绍
2.3.1 参数网分类和组网规模能力
参数网负责连接所有的 GPU 服务器网卡。
当前业界建设规模需要覆盖数百到数 10K,根据当前的交换机的端口密度,通常分为二层 Spine-Leaf 组网,三层 Core-Spine-Leaf 组网。
2.3.2 二层 Spine+leaf 组网
1. 典型组网
以 S9827-128DH 交换机组建 8K 卡规模组网举例如图:
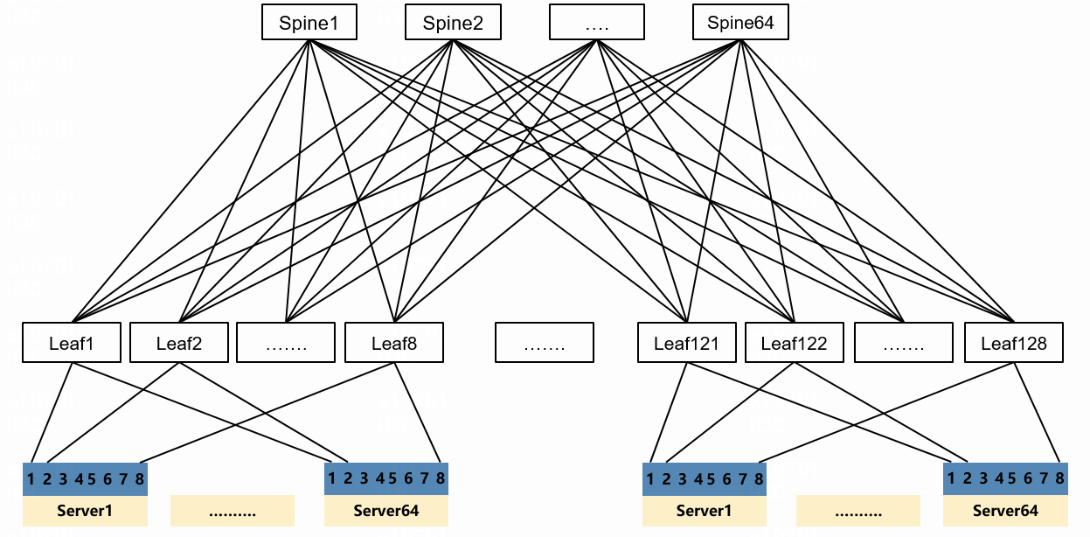
最大组网规模计算公式
Spine 和 Leaf 均使用盒式交换机, Leaf 上下行 1:1 收敛比。
400G 口接入规模计算公式: Spine 的 400G 口数量 *Leaf 的 400G 口数量 /2。
Leaf 设备需求数量
Leaf 数量计算公式: GPU 网卡数量 /Leaf 下行 400G 口数量:
比如 128 口 400G 交换机 S9827-128DH 组建 8K 卡的规模, Leaf 数量 =8K/64=128 台。
比如 128 口 400G 交换机 S9827-128DH 组建 6K 卡的规模, Leaf 数量 =6K/64=96 台。
Spine 设备需求数量
Spine 数量计算公式: GPU 网卡数量 /Spine 下行 400G 口数量:
- 比如 128 口 400G 交换机 S9827-128DH 组建 8K 卡的规模, Spine 数量 =8K/128=64 台。
- 比如 128 口 400G 交换机 S9827-128DH 组建 6K 卡的规模, Spine 数量 =6K/128=48 台。此时需要注意, Spine 数量不是 2 的 N 次方, Leaf 的上行 64 个口不能均匀的分布在 Spine 上, 会出现 Spine 连接不同的 Leaf 端口数量不一致,导致 Leaf 互访出现多打一。故此时建议 Spine 的数量需要增加到 64 台。
总结起来, Spine 的数量,建议是大于计算结果的 2 的 N 次方的数字。
2. 路由规划建议
路由协议选择建议
Underlay 路由协议建议选择 EBGP。
- EBGP 可支持更大规模的组网
BGP 比 IGP 具有更简单的状态机和数据库,路由只在对等体之间单播传播,传播范围更小, 更新方式为增量更新和触发更新,不会泛洪。
BGP 交换的是路由,不需要运行算法 ( 比如 SPF) 来计算路径,不需要因为局部链路故障导致全网重新计算,相对 IGP, BGP 更加稳定,能够支撑更大规模的组网。
EBGP 使用 AS-path 防止环路, IBGP 在同一 AS 内,使用水平分割原则,需要部署 RR 反射器来模拟 EBGP 的行为,建议直接选择 EBGP,也是业界 Underlay 路由协议的常规做法。
- IGP 路由协议容易产生故障后微环
IGP 常用的协议包含 ISIS 和 OSPF,是基于链路状态,采用最短路径 SPF (Shortest Path First) 算法的协议,在网络故障中,由于不同的设备节点,更新链路状态,进行协议计算,收敛的速度存在差异性,可能导致微环的产生。使得流量瞬间在两个节点之间往返,形成瞬间环路, 严重的时候可能触发 PFC 死锁。
- 而 BGP 协议路由控制手段丰富,使用 AS-Path 水平分割防环,设计上保障单节点无次优路由, 就可以有效的降低故障后路由收敛瞬间环路风险。
EBGP 的 AS 规划建议
建议所有的 Spine 使用相同的 AS 号。
建议所有的 Leaf 使用不同的 AS 号,比如使用 100+Leaf 号的方式规划。
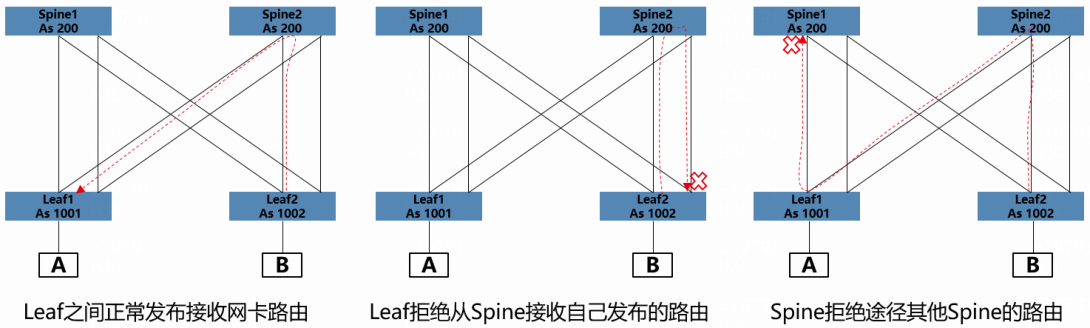
智算参数网,对路由的需求:
Leaf 之间正常发布接收网卡路由
如果 Leaf 的 as 不同,天然可被接收。
如果 Leaf 的 as 相同,需要配置 peer spine allow-as-loop 1 来防止因 as 相同被丢弃。
Leaf 拒绝从 Spine 接收自己发布的路由
如果 Leaf 和 Spine 只有一根线,建立一个 EBGP Peer, Spine 从和 Leaf 的 Peer 接收路由后不会再发布回去;
如果 Leaf 和 Spine 有多根线,建立多个 EBGP Peer, Spine 从和 Leaf 的 Peer1 接收路由后,会从 Peer2 发布回去。
此时如果 Leaf 的 AS 号不同,就不需要配置 peer spine allow-as-loop 1,故 Leaf 将丢弃 Spine 返回来的路由, Leaf 上不会形成次优路由,避免故障收敛过程造成瞬时环路;
此时如果 Leaf 的 AS 号相同,就需要配置 peer spine allow-as-loop 1,故 Leaf 将接收 Spine 返回来的路由, Leaf 上会形成次优路由,故障收敛期间就可能造成瞬时环路;
为了适配各种组网,建议 Leaf 的 as 均不同。
Spine 拒绝途径其他 Spine 的路由
Leaf 发给 Spine 的路由,会再发给其他 Leaf,其他 Leaf 会再发给其他 Spine。
Spine 的 AS 均相同,会丢弃这些途径其他 Spine 的路由,避免流量在网络中绕行。
EBGP 的 Peer 配置建议
- 使用直连链路地址建立 EBGP Peer,而不是环回口地址
首先, Spine 本身无法直接打通到 leaf 的环回口地址,需要通过 IGP 打通,或者借用环回口地址建立 EBGP Peer,增加了路由协议的复杂度,和配置复杂度;
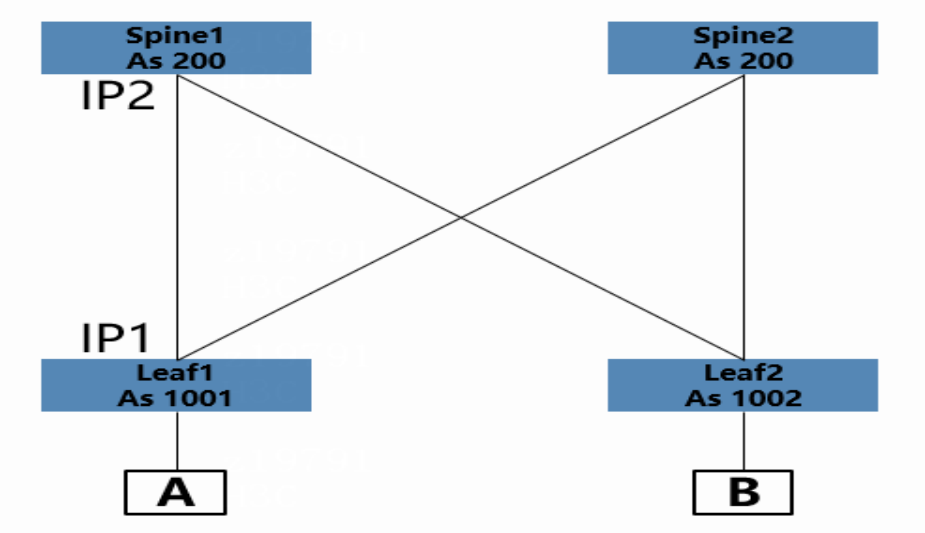
其次,如图,通常为了带内管理,环回口地址路由也会发布到 BGP Peer 内,图中 Spine1 可以从 Leaf1, Leaf2 都学习到 Leaf1 的环回口地址 LP1 的路由,只是优选下一跳是 Leaf1 的。 而当 Spine1 和 Leaf1 的链路故障的时候, Spine1 依然能学习到 Peer 建立的目的地址路由, 导致长时间不能 Peer down 而撤销路由,导致整体故障收敛性能变差,丢包更多。
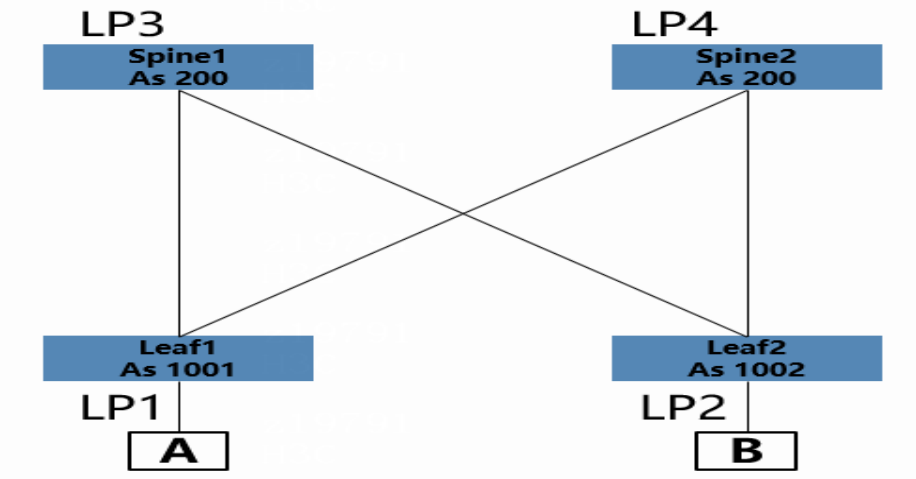
互联链路地址不建议发布到 BGP 路由中
比如 Spine1 和 Leaf1,使用互联链路地址 IP1 和 IP2 建立 EBGP Peer;
如果 Leaf1 将 IP1 发布到 BGP 内,那么其他设备也会学到 IP1 地址路由;
在 Spine1 和 Leaf1 链路故障的时候, Spine1 因为可以从其他设备也学到 IP1,故在收敛瞬间, 会认为 Peer 依然可达,导致收敛变慢,丢包更多。
而且将 Underlay 链路互联地址发布到 BGP 内也不存在业务需求,故不建议。
3. 本场景设备选型建议
Spine 通常需要高密的 200G, 400G, 800G 款型,如:
S9827-128DH, S9827-64EP, S9827-64E, S9825-64DH, S9825-128B。
- 连线部署建议
服务器端口连线 , 请咨询交换机产品部提供连线建议。
2.3.3 三层 Core-Spine-Leaf
三层组网,通常是三层盒盒架构。
三层组网业界存在两种组网形态:
一种是多 POD 组网,单个 POD 是一个 Spine-Leaf 多轨道接入网络,接入一定数量的服务器, 涵盖所有的 8 张 GPU 卡。
一种是多轨道组网,单个 POD 是一个 Spine 单轨道接入网络,共计 8 个 POD,每个 POD 连接一个轨道的 GPU 卡。
这两种组网,最大的差异性在 GPU 服务器接入方式上有区别。
在最大规模的计算公式上,两个组网是一样的。
1. 最大组网规模计算公式
按照 1:1 收敛比说明,如果有收敛比,可按照收敛比减少 Core 的设备和链路数量。
400G 口接入规模计算公式: Core 的 400G 端口数量 *Spine 的 400G 口数量 *Leaf 的 400G 口数量 /4。
最大 400G 接入能力如下:(按照 1:1 收敛比计算)
| Core | 12.8T | 25.6T | 51.2T |
|---|---|---|---|
| Spine | 12.8T | 25.6T | 51.2T |
| Leaf | 12.8T | 25.6T | 51.2T |
|---|---|---|---|
| 400G规模 | 8K | 64K | 512K |
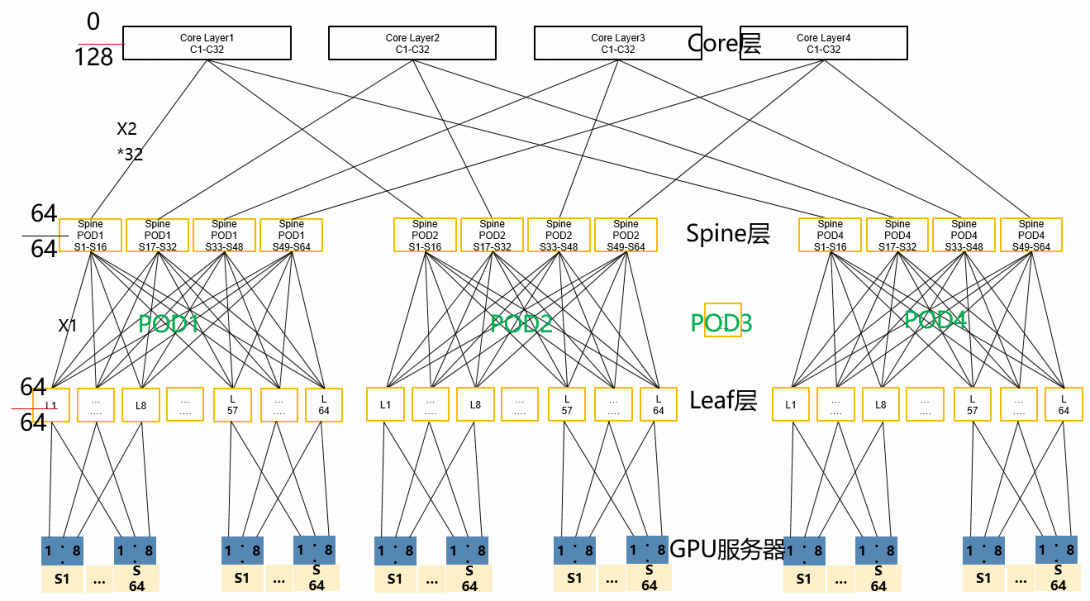
- 典型组网 1— 多 POD 三层组网
以 S9827-128DH 交换机组建 16K 卡集群组网举例如图:
多 POD 三层组网优劣势
优势:初期投资小,可只建设一个 POD,预留 Spine 上行端口,后期按需平滑扩容到三层组网。 劣势:三层组网后,同轨道的 GPU 卡间跨 POD 流量需要上 Core 层,非最优。
POD 数量
多 POD 组网因为 POD 数量不固定,所以先从 POD 的维度计算。
单个 POD 最大接入 GPU 卡数量计算公式: Spine 的 400G 端口数量 /2Leaf 的 400G 端口数量 /2。 比如 128400G 交换机 9827,单个 POD 的接入 GPU 卡数量 =128*128/4=4K。
此时单个 POD 的 Leaf 数量 =64 台, Spine 数量 =64 台, Spine 上行预留 64 个端口。 POD 数量计算公式: GPU 总卡数量 / 单个 POD 最大接入 GPU 卡数量。
比如 16K 组网, POD 数量 =16K/4K=4 个 POD。
比如 15K 组网, POD 数量 =15K/4K=3.75,取到整数是 4 个 POD。
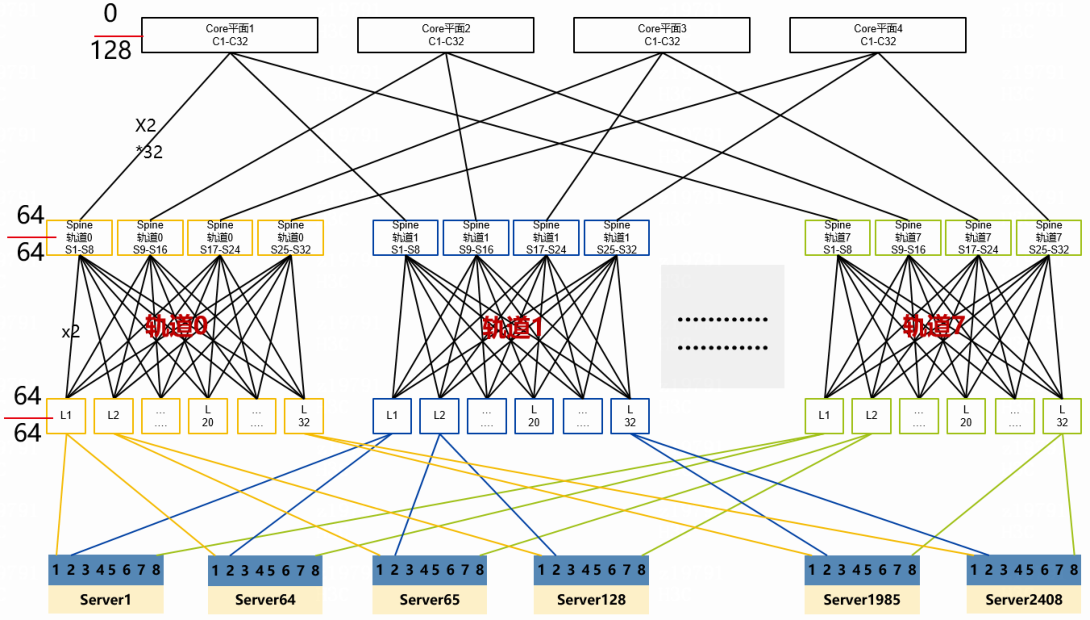
- 典型组网 2— 多轨道三层组网
以 S9827-128DH 交换机组建 16K 卡集群组网举例如图:
多轨道三层组网优劣势
优势:同轨道的 GPU 卡间流量在同一个二层轨道 Spine-Leaf 内部交互,不跨 Core,流量较优。 劣势:轨道数量固定,比如 8 卡服务器就是 8 个轨道,初期投资较大。
POD 数量
比如 8 卡服务器,固定就是 8 个轨道,建设 8 组 Spine-Leaf,和一个核心 Core 层。
4. Leaf 设备需求数量
Leaf 数量计算公式: GPU 网卡数量 /Leaf 下行 400G 口数量:
比如 128 口 400G 交换机 S9827-128DH 组建 16K 卡的规模, Leaf 数量 =16K/64=256 台。
比如 128 口 400G 交换机 S9827-128DH 组建 15K 卡的规模, Leaf 数量 =15K/64=240 台。
- Spine 设备需求数量
Spine 数量计算公式: GPU 网卡数量 /Spine 下行 400G 口数量:
比如 128 口 400G 交换机 S9827-128DH 组建 16K 卡的规模, Spine 数量 =16K/64=256 台;
比如 128 口 400G 交换机 S9827-128DH 组建 15K 卡的规模, Spine 数量 =15K/64=240 台, 此时需要注意, Spine 数量不是 2 的 N 次方, Leaf 的上行 64 个口不能均匀的分布在 Spine 上,会出现 Spine 连接不同的 Leaf 端口数量不一致,导致 Leaf 互访出现多打一。故此时建议每个 POD 的 Spine 的数量都是 64 台,加起来是 256 台。
总体而言, Spine 的数量,建议是每个 POD 都是大于计算结果的 2 的 N 次方的数字。
6. Core 设备需求数量
Core 数量计算公式: GPU 网卡数量 /Core 下行 400G 口数量:
- 比如 128 口 400G 交换机 S9827-128DH 组建 16K 卡的规模, Spine 数量 =16K/128=128 台。
- 比如 128 口 400G 交换机 S9827-128DH 组建 15K 卡的规模, Spine 数量 =15K/128=120 台。 和 Spine 的注意事项一样,建议 Core 数量都是大于计算结果的 2 的 N 次方的数字,这里取 128 台。
7. Core 的分组规划
Spine 上行 64 个端口,需要全连接到 Core,而 Core 的数量是 128 台,故需要将 Core 分组。 单个组内的 Core 的数量,需要是一个 2 的 N 次方数字,且需要小于等于 Spine 上行口数量 64。 Core 分组后,也需要将一个 POD 内的 Spine 分组,一个 Spine 组连接相同的一组 Core。
比如 128 口 400G 交换机 S9827-128DH 组建 16K 卡的规模:
Core 分为 2 组,每组 64 台; Spine 也分为 2 组,每组 32 台。
Core 分为 4 组,每组 32 台, Spine 也分为 4 组,每组 16 台。
- 路由规划建议
路由协议选择建议
Underlay 路由协议建议选择 EBGP。
EBGP 的 AS 规划建议
建议所有的 Core 使用相同的 AS 号。或者是同组的 Core 使用相同的 AS 号,不同组的 Core 使用不同的 AS 号,此时, Leaf 需要配置内容不同但长度相同的 AS_PATH 属性的路由能够形成 BGP 负载分担命令 balance as-path-relax ebgp。
建议同一个 POD 或者同一个轨道的 Spine 使用相同的 AS 号,不同 POD 或者不同轨道的 Spine 使用不同的 AS 号。
建议所有的 Leaf 均使用不同的 AS 号。
EBGP 的 Peer 配置建议
使用直连链路地址建立 EBGP Peer,而不是环回口地址。
互联链路地址不建议发布到 BGP 路由中。
9. 本场景设备选型建议
Spine 通常需要高密的 200G, 400G, 800G 款型,如:
S9825-128DH, S9827-64EP, S9827-64E, S9825-64DH, S9825-128B。
- 连线部署建议
服务器端口连线 , 请咨询交换机产品部提供连线建议。